Agentic Patterns y las Muchas Caras del RAG
Cuando empezás a construir AI-powered apps por primera vez, todo parece simple: un prompt, un modelo, una respuesta. Y funciona — hasta que deja de funcionar. Hasta que el modelo alucina en vez de buscar, elige la herramienta equivocada con una confianza envidiable, o trata una pregunta compleja igual que una trivial.
Lo que buscas a continuación ya no es un prompt. Es un pattern — una forma recurrente de conectar un LLM a un sistema para que se comporte de manera predecible ante entradas del mundo real.
Armé una referencia animada de estos patterns en zerogap.uk/agents. Esta entrada es su complemento escrito.
Empieza con el Single Agent
El punto de partida que recomiendo es el más simple: un modelo con un system prompt y un conjunto definido de herramientas. El agente lee la solicitud del usuario, decide qué herramienta llamar, la llama y sintetiza una respuesta.
No necesitas nada más elaborado hasta que el single agent deje de ser suficiente. Las señales son concretas: alucina en lugar de buscar información, elige la herramienta equivocada con confianza, o responde preguntas rápidas y lentas de la misma manera (mal, para una de ellas).
Ese último síntoma es lo que soluciona el patrón router gate. Un clasificador ligero se sitúa al frente del sistema y decide: esta pregunta va al single agent, aquella va a un pipeline de varios pasos más pesado.
RAG No Es un Patrón — Es una Familia
La razón más común por la que un single agent no es suficiente es que la respuesta está en tus documentos, no en los pesos del modelo. Ahí es donde entra el Retrieval-Augmented Generation (RAG).
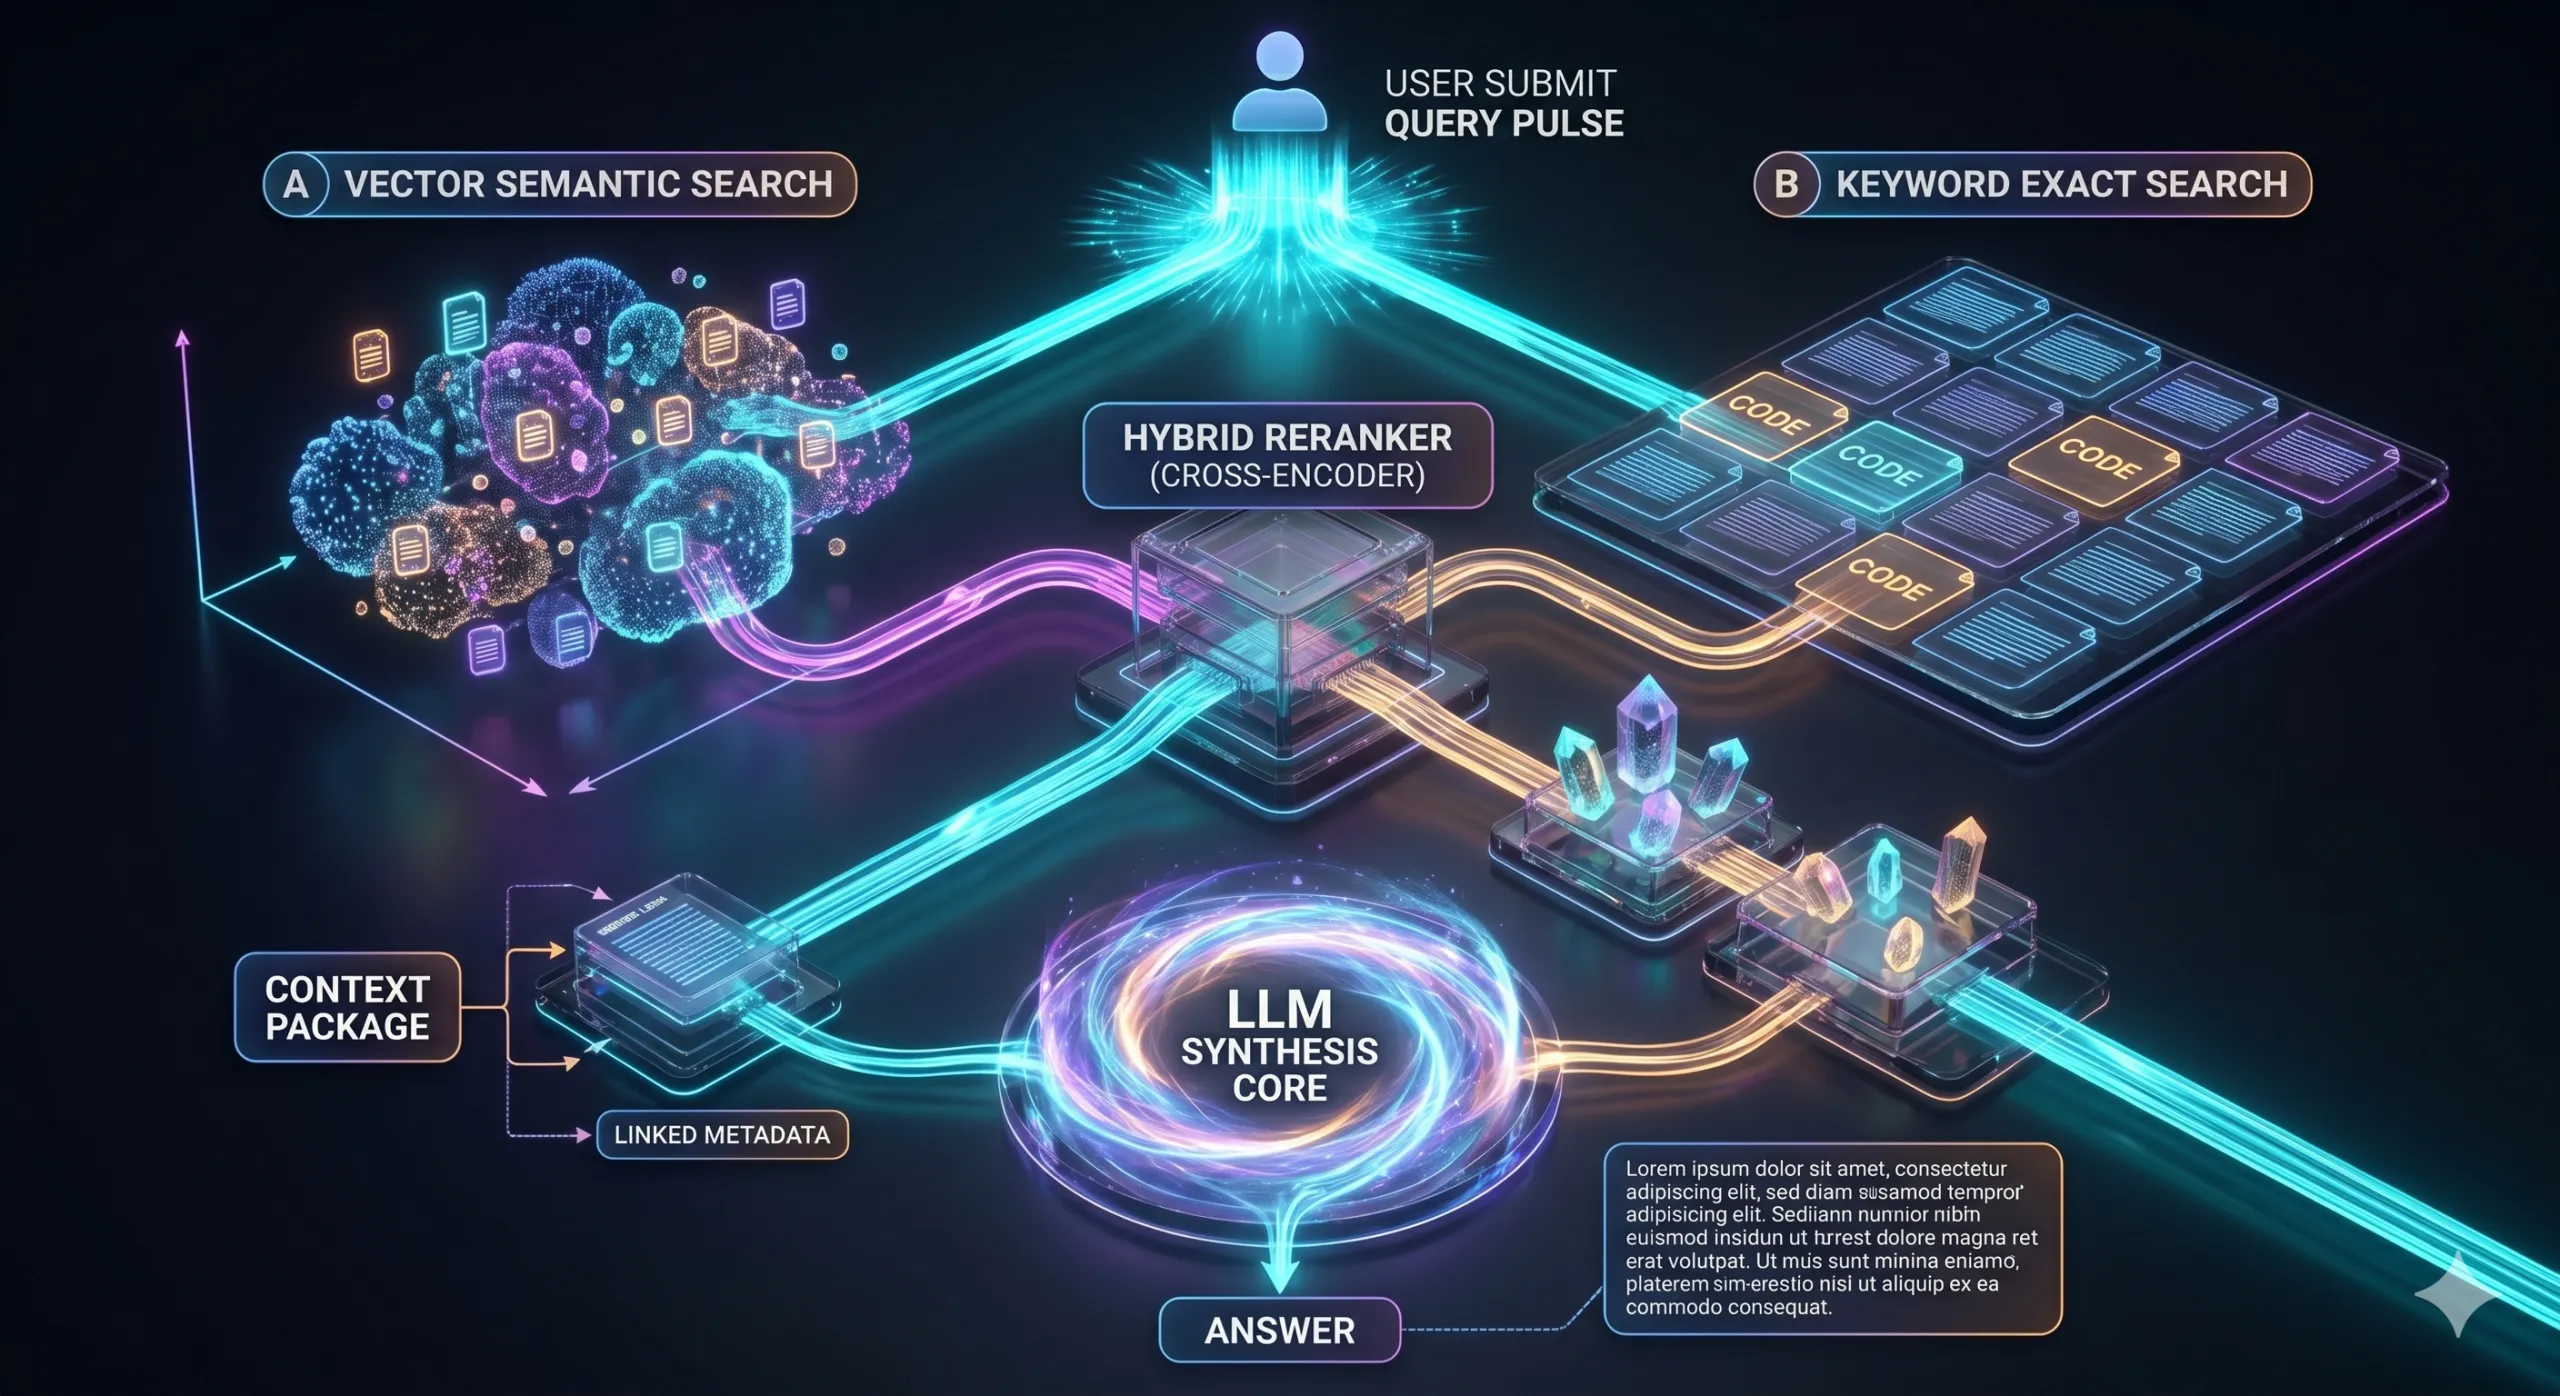
Naive RAG. Embebe la consulta, busca los chunks más cercanos por similitud de coseno, introdúcelos en el prompt. Aparece en todos los tutoriales. Funciona cuando el corpus es pequeño y bien escrito. Falla cuando los usuarios preguntan sobre identificadores exactos, códigos o jerga — la similitud vectorial los suaviza.
Keyword RAG. BM25 o búsqueda léxica similar. El modo de fallo opuesto: excelente para consultas de coincidencia exacta («error code TRX-4012»), peor para entender la intención.
Hybrid RAG. Ejecuta ambos y combínalos. Casi siempre mejor que cualquiera de los dos por separado en producción.
Reranking RAG. Recupera una primera pasada amplia, luego ejecuta un cross-encoder reranker sobre los mejores candidatos. El reranker lee la consulta y el documento juntos, captando la relevancia que la similitud de embeddings pasó por alto.
Agentic RAG. El agente decide si recuperar, qué recuperar y cuándo detenerse. El retrieval se convierte en una herramienta que el modelo puede llamar repetidamente. Más lento, pero maneja preguntas multi-hop que el Naive RAG no puede.
Corrective RAG (CRAG). El agente recupera, luego evalúa lo que recuperó. Si el contexto es débil, reescribe la consulta, recurre a búsqueda web o se niega a responder.
Graph RAG. Recupera de un knowledge graph en lugar de (o junto con) chunks vectoriales. Cuando las relaciones importan — quién reporta a quién, qué productos dependen de qué proveedores — el recorrido del grafo da respuestas que la similitud pura de chunks no puede reconstruir.
Tree-Index RAG (Vectorless). Resúmenes jerárquicos. Los documentos grandes se resumen en múltiples niveles; el retrieval puede llegar a un chunk hoja o subir a un resumen de sección. Útil cuando los context windows son ajustados.
CAG (Cache-Augmented Generation). Cuando tu corpus cabe en el context window de un modelo de contexto largo, omite el retrieval y carga todo con prompt caching. A menudo la respuesta correcta para dominios estrechos con bases de conocimiento estables. Más barato de lo que la gente espera una vez activado el caching.
El árbol de decisión no es «cuál es el mejor» — es «qué modo de fallo estoy tratando de evitar». Elige el más simple que supere tu consulta más difícil, luego añade complejidad cuando una consulta real lo rompa.
Orquestación: Cuando un Solo Agente No Es Suficiente
Más allá del retrieval, la siguiente familia de patterns trata sobre cómo se conectan múltiples pasos o múltiples agentes entre sí.
- Sequential — agente A → agente B → agente C. La salida de cada paso alimenta al siguiente.
- Parallel — distribuye subtareas independientes, combina los resultados.
- Conditional — bifurca según la salida de un paso anterior. Control flow estándar aplicado a llamadas LLM.
- Review-and-critique — un agente produce, otro revisa, el primero corrige. Más lento pero consistentemente eleva la calidad.
- Coordinator — un agente gestor delega a especialistas y ensambla su trabajo. La forma clásica de «equipo de expertos».
- Hierarchical decomposition — divide una tarea grande en subtareas, cada una puede descomponerse aún más.
- Dynamic prompting — el prompt se construye en runtime a partir del contexto del usuario, hechos recuperados y turnos anteriores. Menos un pattern que una disciplina: deja de hardcodear prompts.
- Swarm — muchos agentes ligeros en paralelo con coordinación mínima.
Véelos en Movimiento
Estos patterns son más fáciles de interiorizar cuando puedes verlos. Cada uno en zerogap.uk/agents está animado: ves el flujo de la consulta hacia el agente, las tool calls dispararse, el retrieval ocurrir, la crítica volver.
Si estás construyendo con LLMs y te has preguntado qué pattern necesita realmente tu problema — entra y juega. Las animaciones hacen que los trade-offs sean obvios de una manera que los diagramas solos nunca logran del todo.

AI Platform Engineer & Full-Stack Developer
Building Enterprise Integrations & Automations
- Vibe coding a ciegas: un juego que se ve muy bien y un código que no escala - octubre 6, 2026
- ¿La IA es consciente? No: calcula probabilidades - octubre 4, 2026
- ¿Realmente necesitás WordPress? Migrá tu blog a S3 + CloudFront con Claude en menos de una hora - septiembre 30, 2026