
Agentic Patterns e as muitas faces do RAG
Traduzido do original em espanhol. Ler em espanhol
Quando você começa a construir AI-powered apps pela primeira vez, tudo parece simples: um prompt, um modelo, uma resposta. E funciona — até deixar de funcionar. Até o modelo alucinar em vez de buscar, escolher a ferramenta errada com uma confiança invejável ou tratar uma pergunta complexa igual a uma trivial.
O que você procura a seguir já não é um prompt. É um pattern — uma forma recorrente de conectar um LLM a um sistema para que ele se comporte de maneira previsível diante de entradas do mundo real.
Montei uma referência animada desses patterns em agents.zerogap.uk. Este post é o complemento escrito dela.
Comece pelo Single Agent
O ponto de partida que recomendo é o mais simples: um modelo com um system prompt e um conjunto definido de ferramentas. O agente lê a solicitação do usuário, decide qual ferramenta chamar, chama e sintetiza uma resposta.
Você não precisa de nada mais elaborado até o single agent deixar de ser suficiente. Os sinais são concretos: ele alucina em vez de buscar informação, escolhe a ferramenta errada com confiança ou responde perguntas rápidas e lentas do mesmo jeito (mal, para uma delas).
Esse último sintoma é o que o padrão router gate resolve. Um classificador leve fica na frente do sistema e decide: esta pergunta vai para o single agent, aquela vai para um pipeline de várias etapas mais pesado.
RAG não é um padrão — é uma família
O motivo mais comum para um single agent não ser suficiente é que a resposta está nos seus documentos, não nos pesos do modelo. É aí que entra o Retrieval-Augmented Generation (RAG).
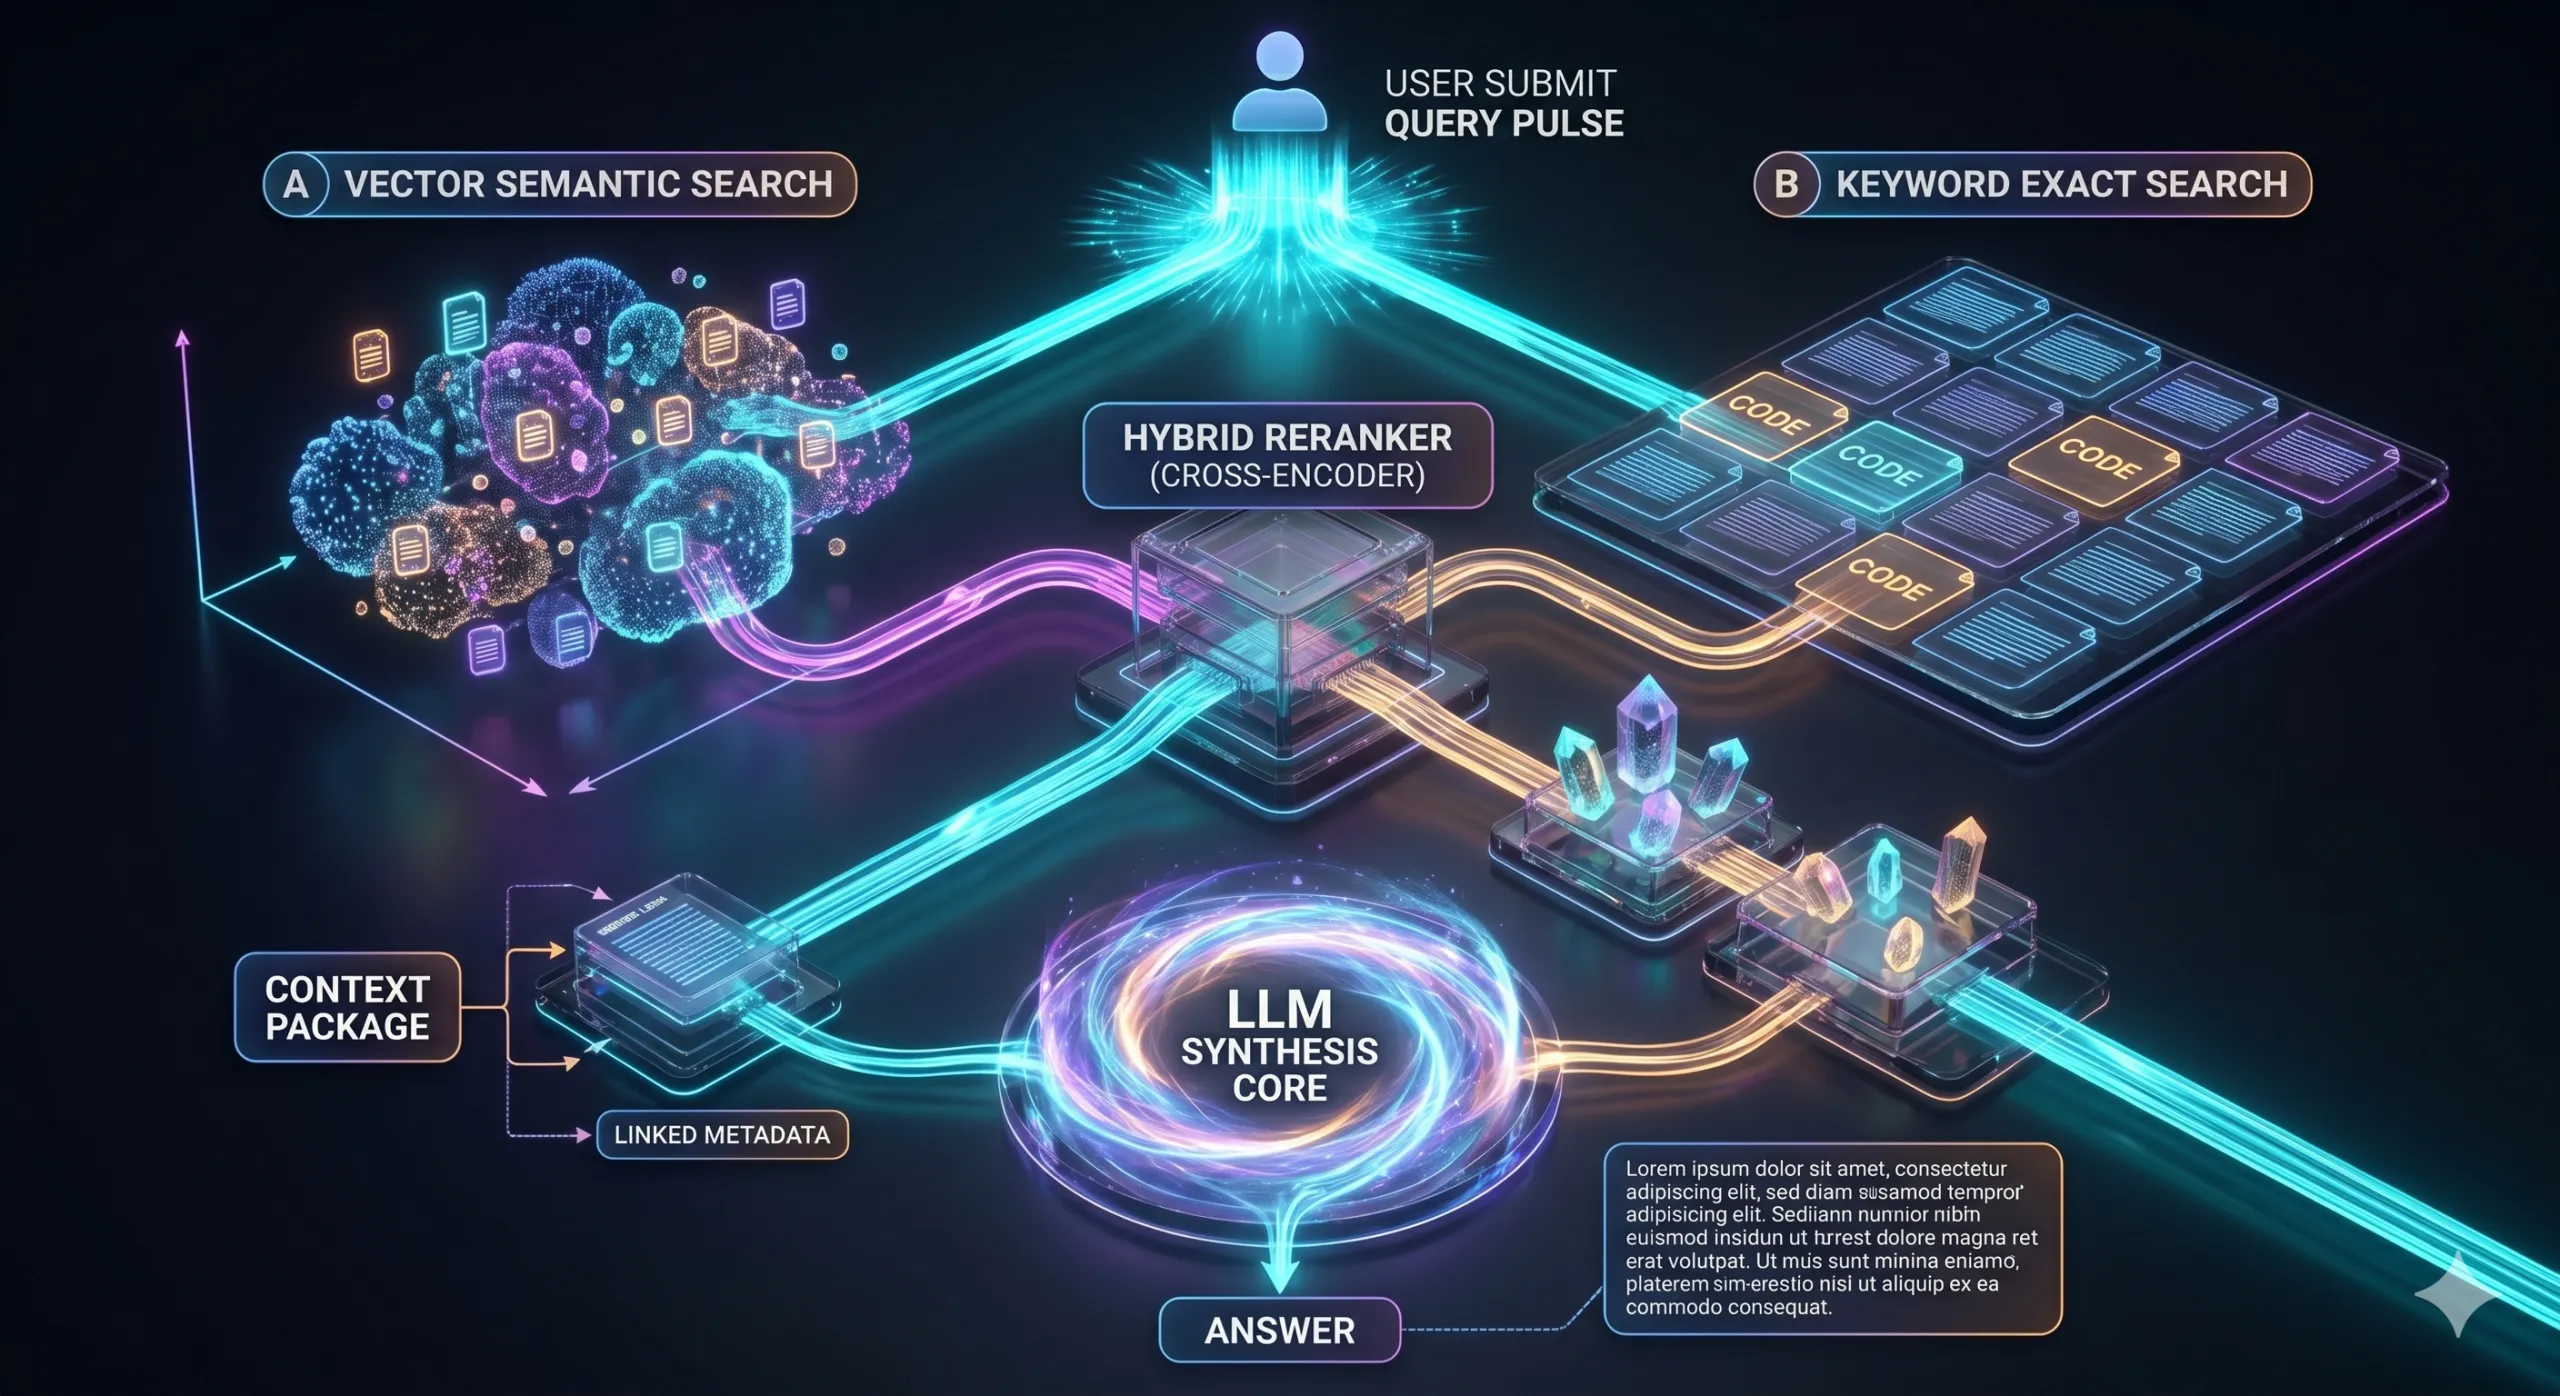
Naive RAG. Gera o embedding da consulta, busca os chunks mais próximos por similaridade de cosseno e os coloca no prompt. Aparece em todos os tutoriais. Funciona quando o corpus é pequeno e bem escrito. Falha quando os usuários perguntam sobre identificadores exatos, códigos ou jargão — a similaridade vetorial os suaviza.
Keyword RAG. BM25 ou busca léxica semelhante. O modo de falha oposto: excelente para consultas de correspondência exata («error code TRX-4012»), pior para entender a intenção.
Hybrid RAG. Executa os dois e os combina. Quase sempre é melhor em produção do que qualquer um dos dois isoladamente.
Reranking RAG. Recupera uma primeira passada ampla e depois roda um cross-encoder reranker sobre os melhores candidatos. O reranker lê a consulta e o documento juntos, captando a relevância que a similaridade de embeddings deixou passar.
Agentic RAG. O agente decide se vai recuperar, o que recuperar e quando parar. O retrieval vira uma ferramenta que o modelo pode chamar repetidamente. Mais lento, mas resolve perguntas multi-hop que o Naive RAG não consegue.
Corrective RAG (CRAG). O agente recupera e depois avalia o que recuperou. Se o contexto for fraco, reescreve a consulta, recorre à busca na web ou se recusa a responder.
Graph RAG. Recupera de um knowledge graph em vez de (ou junto com) chunks vetoriais. Quando as relações importam — quem se reporta a quem, quais produtos dependem de quais fornecedores — percorrer o grafo dá respostas que a similaridade pura de chunks não consegue reconstruir.
Tree-Index RAG (Vectorless). Resumos hierárquicos. Os documentos grandes são resumidos em vários níveis; o retrieval pode chegar a um chunk folha ou subir para um resumo de seção. Útil quando as context windows são apertadas.
CAG (Cache-Augmented Generation). Quando o seu corpus cabe na context window de um modelo de contexto longo, pule o retrieval e carregue tudo com prompt caching. Muitas vezes é a resposta certa para domínios estreitos com bases de conhecimento estáveis. Mais barato do que as pessoas esperam depois que o caching é ativado.
A árvore de decisão não é «qual é o melhor» — é «qual modo de falha estou tentando evitar». Escolha o mais simples que passe na sua consulta mais difícil e depois adicione complexidade quando uma consulta real o quebrar.
Orquestração: quando um só agente não basta
Além do retrieval, a próxima família de patterns trata de como várias etapas ou vários agentes se conectam entre si.
- Sequential — agente A → agente B → agente C. A saída de cada etapa alimenta a seguinte.
- Parallel — distribui subtarefas independentes e combina os resultados.
- Conditional — ramifica de acordo com a saída de uma etapa anterior. Control flow padrão aplicado a chamadas de LLM.
- Review-and-critique — um agente produz, outro revisa, o primeiro corrige. Mais lento, mas eleva a qualidade de forma consistente.
- Coordinator — um agente gerente delega a especialistas e monta o trabalho deles. A forma clássica de «equipe de especialistas».
- Hierarchical decomposition — divide uma tarefa grande em subtarefas, cada uma das quais pode ser decomposta ainda mais.
- Dynamic prompting — o prompt é montado em runtime a partir do contexto do usuário, dos fatos recuperados e dos turnos anteriores. Menos um pattern do que uma disciplina: pare de fazer hardcode de prompts.
- Swarm — muitos agentes leves em paralelo, com coordenação mínima.
Veja-os em movimento
Esses patterns são mais fáceis de absorver quando você consegue vê-los. Cada um deles em agents.zerogap.uk é animado: você vê a consulta fluir até o agente, as tool calls dispararem, o retrieval acontecer, a crítica voltar.
Se você está construindo com LLMs e já se perguntou de qual pattern o seu problema realmente precisa — entre e brinque. As animações deixam os trade-offs óbvios de um jeito que diagramas sozinhos nunca conseguem totalmente.

AI Platform Engineer & Full-Stack Developer
Building Enterprise Integrations & Automations
- O que é realmente um LLM — e como medi-lo com o Artificial Analysis - 12 de setembro de 2026
- AI SDLC: um compêndio de boas práticas para desenvolver com IA - 19 de junho de 2026
- Agentic Patterns e as muitas faces do RAG - 25 de maio de 2026