
Agentic Patterns e le molte facce del RAG
Tradotto dall'originale in spagnolo. Leggi in spagnolo
Quando inizi a costruire app basate sull’IA per la prima volta, tutto sembra semplice: un prompt, un modello, una risposta. E funziona — finché non smette di funzionare. Finché il modello allucina invece di cercare, sceglie lo strumento sbagliato con una sicurezza invidiabile o tratta una domanda complessa esattamente come una banale.
Quello che ti serve a quel punto non è più un prompt. È un pattern — un modo ricorrente di collegare un LLM a un sistema perché si comporti in modo prevedibile davanti agli input del mondo reale.
Ho messo insieme un riferimento animato di questi pattern su agents.zerogap.uk. Questo post ne è il complemento scritto.
Inizia dal Single Agent
Il punto di partenza che consiglio è il più semplice: un modello con un system prompt e un insieme definito di strumenti. L’agente legge la richiesta dell’utente, decide quale strumento chiamare, lo chiama e sintetizza una risposta.
Non ti serve niente di più elaborato finché il single agent basta. I segnali sono concreti: allucina invece di cercare informazioni, sceglie lo strumento sbagliato con sicurezza, oppure risponde allo stesso modo alle domande rapide e a quelle lente (male, per una delle due).
Quest’ultimo sintomo è quello che risolve il pattern router gate. Un classificatore leggero si mette davanti al sistema e decide: questa domanda va al single agent, quella va a una pipeline più pesante a più passaggi.
Il RAG non è un pattern — è una famiglia
Il motivo più comune per cui un single agent non basta è che la risposta sta nei tuoi documenti, non nei pesi del modello. È qui che entra in gioco il Retrieval-Augmented Generation (RAG).
Naive RAG. Calcola l’embedding della query, cerca i chunk più vicini per similarità del coseno e inseriscili nel prompt. È in ogni tutorial. Funziona quando il corpus è piccolo e ben scritto. Fallisce quando gli utenti chiedono di identificatori esatti, codici o gergo — la similarità vettoriale li appiattisce.
Keyword RAG. BM25 o una ricerca lessicale simile. Il modo di fallire opposto: ottimo per le query a corrispondenza esatta («error code TRX-4012»), peggiore nel capire l’intento.
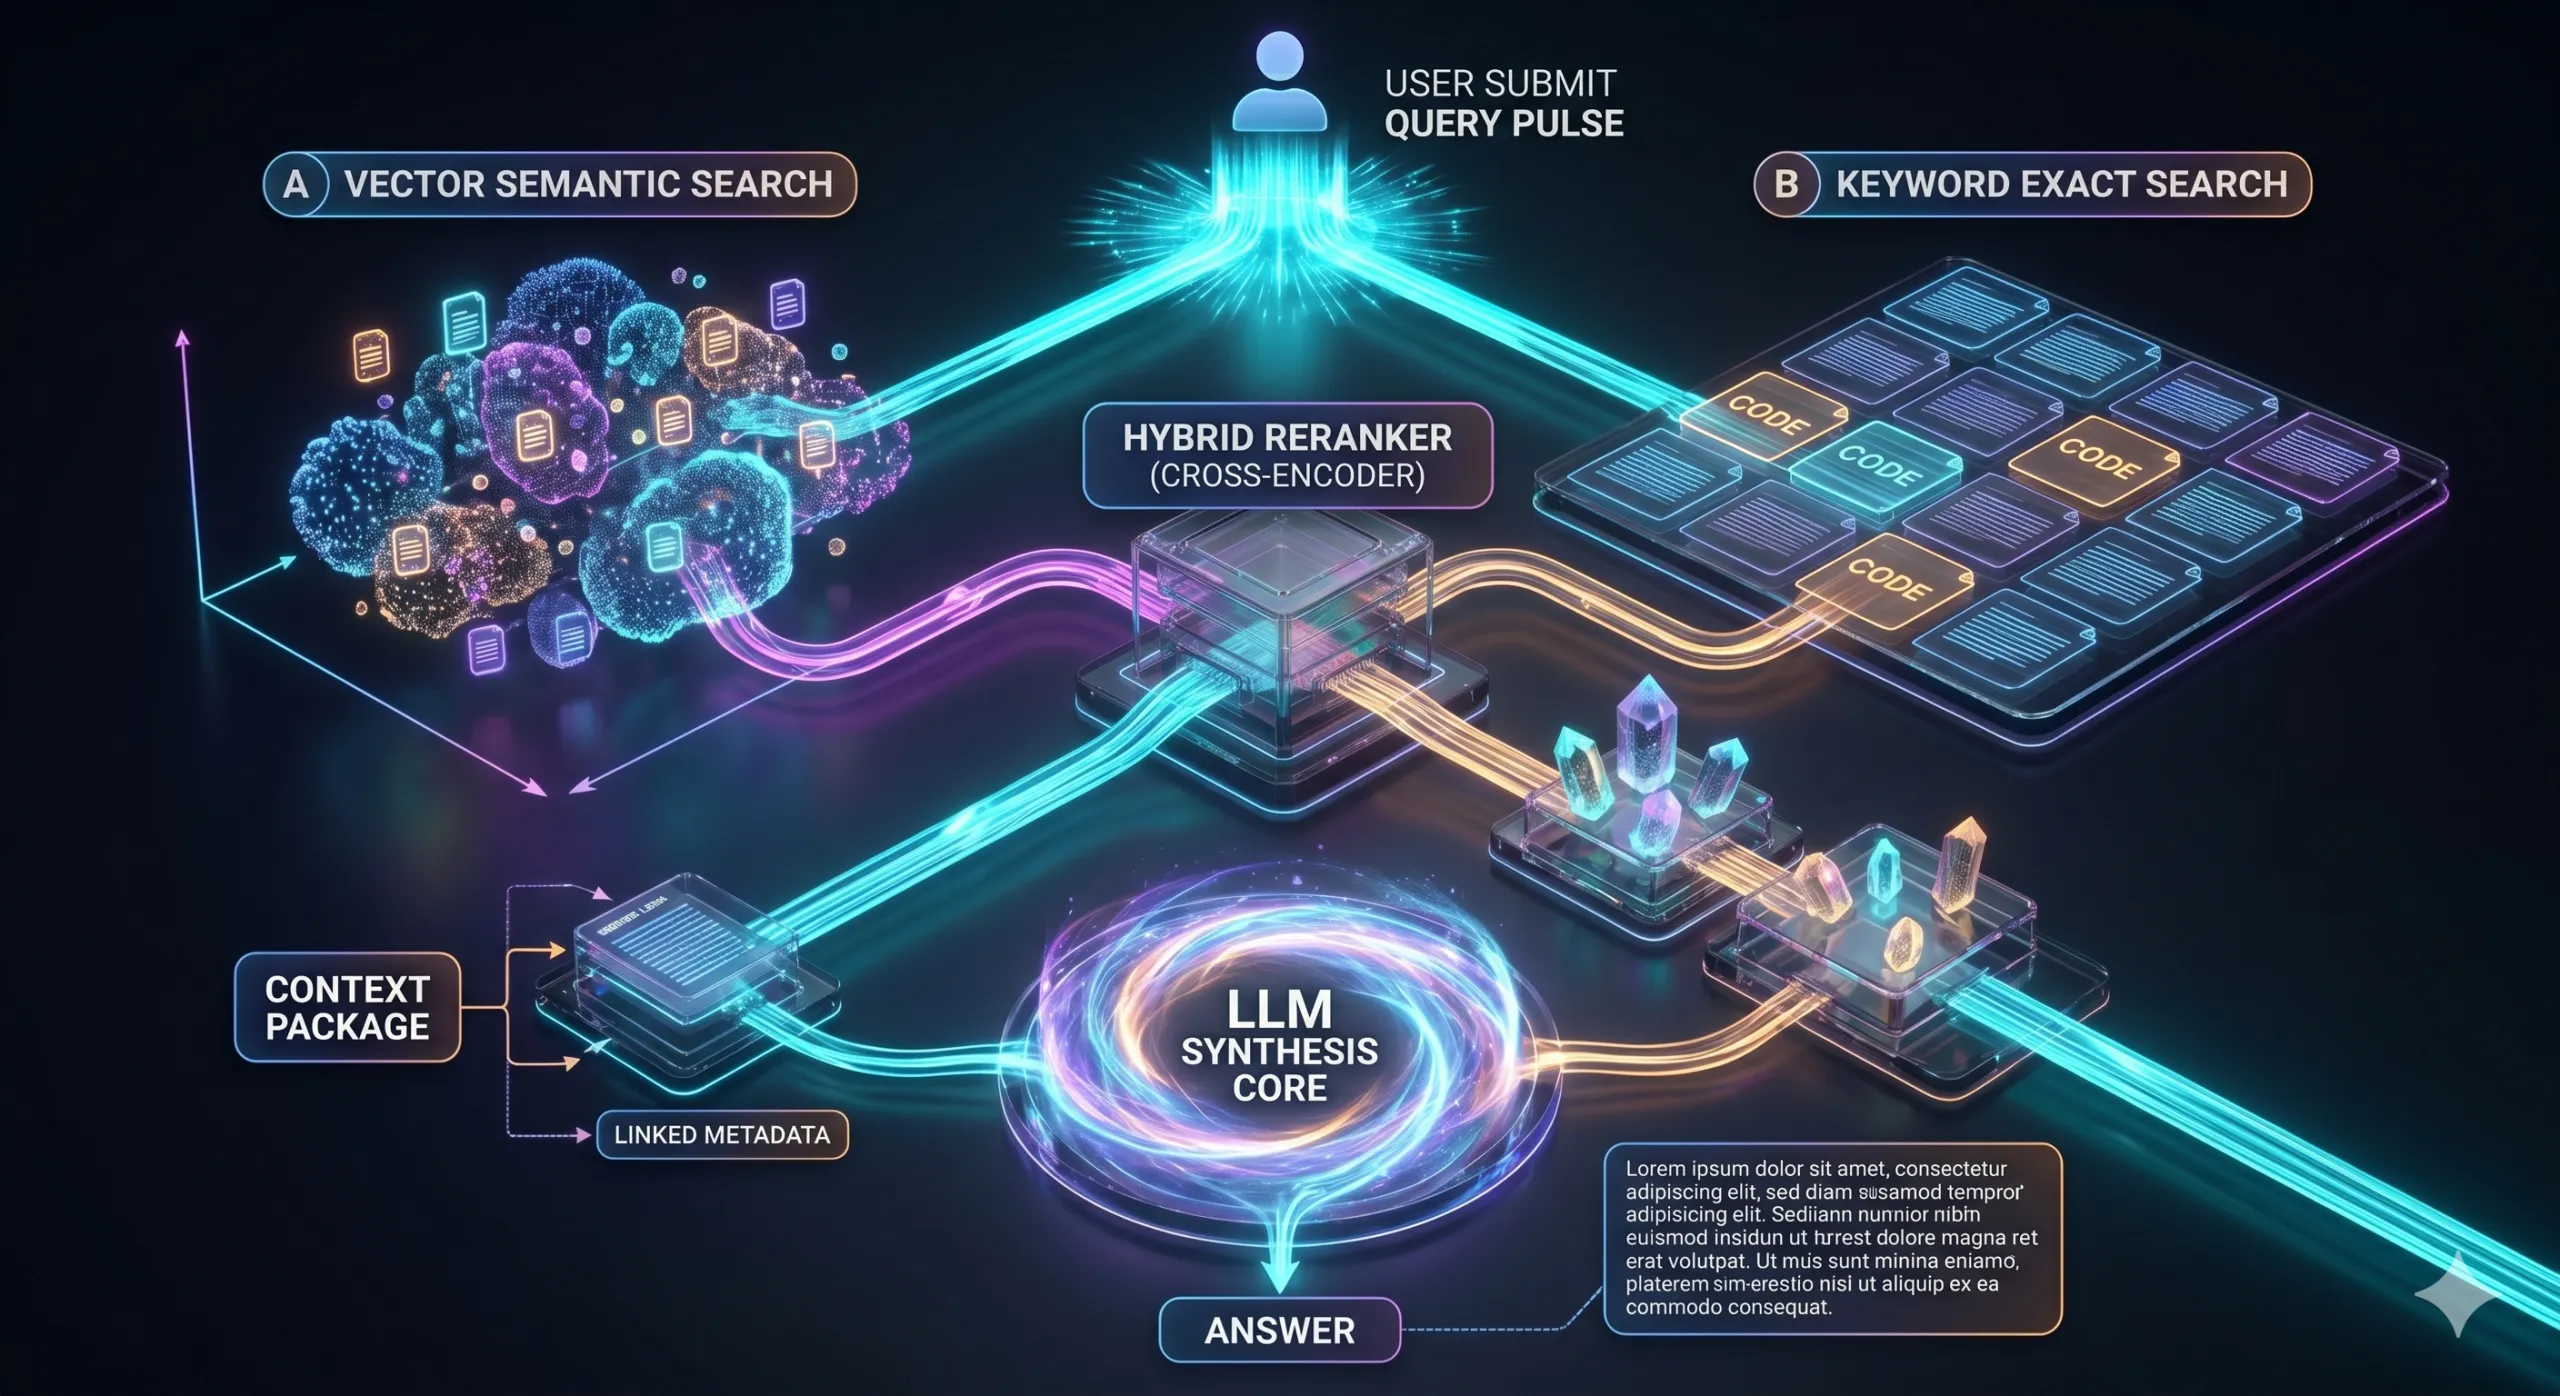
Hybrid RAG. Esegui entrambi e combinali. In produzione è quasi sempre meglio di ciascuno dei due preso da solo.
Reranking RAG. Recupera una prima passata ampia, poi esegui un cross-encoder reranker sui migliori candidati. Il reranker legge insieme query e documento, cogliendo la rilevanza che la similarità degli embedding si era persa.
Agentic RAG. L’agente decide se recuperare, cosa recuperare e quando fermarsi. Il retrieval diventa uno strumento che il modello può chiamare più volte. Più lento, ma gestisce le domande multi-hop che il Naive RAG non riesce a gestire.
Corrective RAG (CRAG). L’agente recupera e poi valuta ciò che ha recuperato. Se il contesto è debole, riscrive la query, ripiega sulla ricerca web o si rifiuta di rispondere.
Graph RAG. Recupera da un knowledge graph invece che da (o insieme a) chunk vettoriali. Quando contano le relazioni — chi riporta a chi, quali prodotti dipendono da quali fornitori — l’attraversamento del grafo dà risposte che la sola similarità tra chunk non può ricostruire.
Tree-Index RAG (Vectorless). Riassunti gerarchici. I documenti grandi vengono riassunti a più livelli; il retrieval può arrivare a un chunk foglia o risalire a un riassunto di sezione. Utile quando le context window sono strette.
CAG (Cache-Augmented Generation). Quando il tuo corpus sta nella context window di un modello a contesto lungo, salta il retrieval e carica tutto con il prompt caching. Spesso è la risposta giusta per domini ristretti con knowledge base stabili. Costa meno di quanto si pensi una volta attivato il caching.
L’albero decisionale non è «qual è il migliore» — è «quale modo di fallire sto cercando di evitare». Scegli il più semplice che supera la tua query più difficile, poi aggiungi complessità quando una query reale lo rompe.
Orchestrazione: quando un solo agente non basta
Oltre al retrieval, la famiglia successiva di pattern riguarda come più passaggi o più agenti si collegano tra loro.
- Sequential — agente A → agente B → agente C. L’output di ogni passaggio alimenta il successivo.
- Parallel — distribuisci sottoattività indipendenti e combina i risultati.
- Conditional — dirama in base all’output di un passaggio precedente. Control flow standard applicato alle chiamate LLM.
- Review-and-critique — un agente produce, un altro rivede, il primo corregge. Più lento, ma alza costantemente la qualità.
- Coordinator — un agente manager delega a specialisti e assembla il loro lavoro. La classica forma a «squadra di esperti».
- Hierarchical decomposition — dividi un compito grande in sottocompiti, ognuno dei quali può essere ulteriormente scomposto.
- Dynamic prompting — il prompt viene costruito a runtime a partire dal contesto dell’utente, dai fatti recuperati e dai turni precedenti. Più una disciplina che un pattern: smetti di scrivere i prompt hardcoded.
- Swarm — tanti agenti leggeri in parallelo, con un coordinamento minimo.
Guardali in movimento
Questi pattern si assimilano più facilmente quando puoi vederli. Ognuno di essi su agents.zerogap.uk è animato: vedi la query scorrere verso l’agente, le tool call partire, il retrieval avvenire, la critica tornare indietro.
Se stai costruendo con gli LLM e ti sei chiesto di quale pattern abbia davvero bisogno il tuo problema — entra e gioca. Le animazioni rendono ovvi i trade-off in un modo che i soli diagrammi non riescono mai del tutto a ottenere.

AI Platform Engineer & Full-Stack Developer
Building Enterprise Integrations & Automations
- Che cos'è davvero un LLM — e come misurarlo con Artificial Analysis - 12 settembre 2026
- AI SDLC: una raccolta di buone pratiche per sviluppare con l'IA - 19 giugno 2026
- Agentic Patterns e le molte facce del RAG - 25 maggio 2026