
Architettura di un agente — Infrastruttura in produzione
Tradotto dall'originale in spagnolo. Leggi in spagnolo
Questo articolo descrive un possibile design per un’infrastruttura di agente di livello produzione su AWS.
Non esiste un’unica architettura corretta per mettere in produzione un agente di IA. Il design giusto dipende dalla tua scala, dai requisiti di conformità e da quanta complessità operativa sei disposto a sostenere. Quella che segue è un’opzione concreta — non l’unico modo, ma un approccio ragionato e di livello produzione che riflette decisioni infrastrutturali reali.
Compute — AWS ECS Fargate
Due cluster: produzione (sempre attivo, alta disponibilità) e sviluppo (50% di uptime, scala a zero fuori dall’orario lavorativo). Ognuno esegue due servizi.
- L’applicazione dell’agente gestisce le chiamate all’LLM, l’orchestrazione dei diversi nodi, il coordinamento degli strumenti e un’interfaccia di amministrazione. Per il RAG interroga
pgvector. Per il CAG carica direttamente i payload di contesto completo. Dimensionata a1 vCPU / 2 GB. - Il proxy MCP astrae l’orchestrazione dei diversi server MCP, instradando le chiamate agli strumenti verso MCP esterni. È disaccoppiato dal runtime dell’agente — permette di aggiungere o cambiare MCP senza dover fare un nuovo deployment dell’applicazione principale. Anch’esso a
1 vCPU / 2 GB.
Alta disponibilità in produzione
Minimo due task distribuiti su più Availability Zone. I task non integri vengono deregistrati e sostituiti automaticamente. I rolling deployment girano con il 100% minimo integro / 200% massimo — zero downtime. L’Auto Scaling regola il numero di task in base a obiettivi di CPU e memoria tramite CloudWatch.
Cluster di sviluppo
Il cluster di sviluppo non fa solo da staging. Addestramento, valutazione e test di integrazione girano qui, nella stessa finestra del 50% di uptime. Nessun task pianificato separatamente, nessun costo di compute aggiuntivo. Scala a zero fuori orario tramite la pianificazione dei servizi ECS.
CI/CD — GitLab
GitLab guida l’intera pipeline di deployment. I commit sulla branch di staging avviano l’Eval Pipeline nel cluster di sviluppo. Superare la valutazione sblocca la fase di deployment, che promuove le modifiche in produzione tramite un rolling update di ECS. Le modifiche ai prompt, gli aggiornamenti dei modelli e le modifiche alla configurazione dell’agente passano tutti dalla stessa pipeline — niente arriva in produzione senza aver prima superato una valutazione automatizzata. Diamo per scontato che GitLab faccia parte della piattaforma esistente, quindi non c’è alcun costo infrastrutturale aggiuntivo.
In caso di failover di DR, la pipeline di GitLab viene reindirizzata verso la regione di DR. Stessa definizione di pipeline, stessi controlli, destinazione di deployment diversa.
Ingestione della KB — AWS Lambda
La pipeline di ingestione gira in modalità serverless. Trasforma i dati di origine grezzi in contenuto pulito e strutturato, scrivendo gli embedding in pgvector per il RAG e preparando i payload di contesto completo per il CAG. Costo zero a riposo, fatturato per invocazione.
Observability — Arize Phoenix
Phoenix gira come servizio Fargate self-hosted, costruito appositamente per l’observability degli LLM. Traccia l’intera catena dell’agente — chiamate all’LLM, esecuzione degli strumenti via MCP, percorsi di recupero e risposte del modello. Dimensionato a 0.5 vCPU / 1 GB. Salva tutti i dati di trace nell’istanza RDS PostgreSQL esistente — non serve un livello di archiviazione separato.
Tutta la telemetria resta in-VPC. Nessun dato esce verso un SaaS di terze parti.
CloudWatch gestisce il livello infrastrutturale — metriche di ECS, monitoraggio degli obiettivi di Auto Scaling e allarmi per i task falliti o le soglie di RDS. Phoenix gestisce la catena dell’LLM. I due si completano invece di sovrapporsi.
Archiviazione — Un’istanza RDS, quattro funzioni
Strategia di archiviazione: un’unica istanza RDS
Consolidare la configurazione dell’app, la memoria conversazionale, l’archiviazione vettoriale e le tracce di Phoenix su un’unica istanza db.m7g.large (2 vCPU, 8 GB di RAM) è una scelta che bilancia il costo con la reale capacità di carico. A differenza delle istanze burstable della famiglia t4g, la m7g.large fornisce i suoi 2 vCPU completi in modo continuativo — niente crediti CPU, nessun degrado sotto carico continuo. Questo è fondamentale quando le ricerche vettoriali di pgvector competono con le scritture di telemetria di Phoenix, perché entrambi i carichi sono intensivi per la CPU e possono coincidere in condizioni di concorrenza reale.
- Capacità: con 2 vCPU dedicati e 8 GB di RAM, questa istanza supporta tranquillamente fino a 80 utenti simultanei che eseguono contemporaneamente ricerche vettoriali, scritture di telemetria e query sulla memoria conversazionale. Gli 8 GB di RAM permettono inoltre a pgvector di tenere in memoria una parte significativa dell’indice vettoriale, riducendo la pressione sul disco.
- Criterio di scalabilità: se il traffico simultaneo sostenuto supera stabilmente gli 80 utenti, il passo naturale successivo è spostare Phoenix su un’istanza propria (es.
db.t4g.small— la telemetria non è sul percorso critico della richiesta, quindi basta un’istanza burstable) e valutare uno scaling verticale dell’istanza principale adb.m7g.xlarge. In alternativa, migrare pgvector su un database vettoriale dedicato se l’indice cresce oltre quanto una singola istanza PostgreSQL può servire in modo efficiente.
L’istanza PostgreSQL (db.m7g.large, 50 GB gp3) dispone di snapshot giornalieri e di una standby replica Multi-AZ. In caso di guasto, RDS esegue un failover automatico sulla replica di riserva senza perdita di dati.
Rete — ALB con SSO
Un unico ALB si trova davanti all’interfaccia di amministrazione per la configurazione dell’agente, la modifica dei prompt, la gestione degli strumenti e la revisione human-in-the-loop. Terminazione TLS e autenticazione OIDC tramite Okta o qualsiasi altro provider di identità (IdP). L’endpoint di health check dell’ALB è monitorato da Route 53 come innesco del failover di DR.
Disaster Recovery (DR) — Pilot Light multi-regione
Lo stack principale gira in us-east-1. La regione di DR è us-west-2.
La replica asincrona di RDS tra regioni alimenta una replica di lettura in us-west-2. Il ritardo di replica è di solito inferiore a un minuto, il che dà un RPO inferiore a un minuto. In un failover regionale, la replica viene promossa a database principale indipendente e lo stack di DR punta su di essa.
Tutti i cluster Fargate nella regione di DR funzionano con un numero desiderato pari a zero durante le operazioni normali — non ci sono task in esecuzione; il compute applicativo si avvia durante il failover, mentre il resto dell’infrastruttura di DR resta pre-provisionato. È il pattern pilot light. Le immagini dei container sono disponibili tramite la replica tra regioni di ECR. Gli health check di Route 53 monitorano l’ALB principale. In caso di guasto, il DNS passa all’ALB di DR con un TTL di 60 secondi. GitLab reindirizza verso us-west-2. ECS scala i cluster di DR. Phoenix nella regione di DR si attiva e punta alla replica promossa. La pipeline Lambda della KB in us-west-2 — già distribuita in modo identico — inizia a scrivere sul database promosso.
L’RTO con questa configurazione è di circa 15 minuti, a seconda di quanto rapidamente viene rilevato il guasto e avviata la sequenza di DR. Se lo SLA richiede un RTO inferiore a cinque minuti, i cluster Fargate di DR dovrebbero funzionare con un numero desiderato pari a uno (warm standby) invece di zero, il che aggiunge circa 72 $ al mese.
Il design attivo-attivo multi-regione è un’architettura completamente diversa — richiede la gestione di uno stato distribuito e la risoluzione dei conflitti per le scritture su RDS. Per la maggior parte dei carichi di lavoro degli agenti, un DR in modalità pilot light con un RTO di circa 15 minuti è il giusto equilibrio.
Il ciclo di miglioramento continuo
Senza un ciclo di feedback, l’agente va alla deriva. La qualità dei prompt peggiora, le conoscenze diventano obsolete e nessuno se ne accorge finché gli utenti non si lamentano. Questo ciclo gira nel cluster di sviluppo e subordina ogni modifica a una valutazione automatizzata e all’approvazione umana.
- Analisi delle interazioni: estrae i log delle conversazioni da RDS e i dati di trace da Phoenix. Un LLM valuta la qualità delle interazioni e fa emergere schemi di degrado — risposte poco affidabili, fallback, chiamate agli strumenti fallite, correzioni degli utenti, sessioni abbandonate.
- Ottimizzazione di prompt e CAG: propone modifiche alle istruzioni di sistema, agli esempi few-shot, ai guardrail e ai template dei prompt. Per il CAG, attiva la Lambda della KB per rigenerare i payload di contesto obsoleti. Tutte le modifiche sono versionate e ricevono un commit su una branch di staging in GitLab.
- Valutazione automatizzata: GitLab rileva il commit su staging e avvia l’Eval Pipeline nel cluster di sviluppo. Regressione sul golden dataset, confronto A/B, benchmark di latenza, correttezza delle chiamate agli strumenti. Se passa — si sblocca la fase di deploy. Se fallisce — la pipeline si ferma.
- Human-in-the-Loop: i risultati della valutazione, i diff e i confronti prima/dopo vengono mostrati nell’interfaccia di amministrazione tramite l’ALB. È richiesta un’approvazione esplicita. Senza eccezioni.
- Promozione in produzione: GitLab esegue il rolling update di ECS sul cluster di produzione in
us-east-1. Phoenix monitora le prime ore di traffico. Rollback automatico se viene rilevata una regressione.
Le interazioni in produzione alimentano il ciclo successivo. Il ciclo si autoalimenta.
Costo mensile dell’infrastruttura
Regione principale (us-east-1):
- Fargate Produzione (2 servizi × 2 task, 1 vCPU / 2 GB) — $144.16
- Fargate Sviluppo (2 servizi × 1 task, 50% di uptime) — $36.04
- Phoenix — $18.02
- Lambda — ~$1.00
- RDS Multi-AZ + pgvector (db.m7g.large, 50 GB gp3) — $256.78
- ALB + CloudWatch + ECR + Secrets — $28.03
- Totale principale — ~$484/mese
Regione di DR (us-west-2, pilot light):
- Replica di lettura RDS tra regioni (db.m7g.large, 50 GB gp3) — $128.39
- ALB pre-provisionato — $16.00
- Health check di Route 53 + instradamento di failover — $4.00
- Replica ECR tra regioni — ~$1.00
- Cluster Fargate (desiderato: 0, inattivi) — $0.00
- Phoenix DR + Lambda DR (inattivi) — $0.00
- DR aggiuntivo — ~$149/mese
Totale con DR — ~$633/mese
La replica RDS tra regioni rappresenta la maggior parte del costo del DR. Fargate non genera costi finché non ci sono task in esecuzione. Attivare il compute di DR in un vero failover aggiunge i costi di Fargate e Phoenix per quel mese, ma si tratta di picchi una tantum e non di spese continue.
La differenza di costo rispetto a un’istanza burstable equivalente in Multi-AZ (db.t4g.medium, ~$106/mese archiviazione inclusa) è di circa $150/mese nella regione principale. Questo aumento elimina del tutto il rischio di degrado per esaurimento dei crediti CPU — un trade-off giustificato quando servono prestazioni prevedibili con una concorrenza reale.
Una precisazione sulla capacità di carico
Questa architettura di base, con il suo dimensionamento iniziale (container Fargate da 1 vCPU / 2 GB e un’istanza RDS db.m7g.large), è pensata per un carico medio-basso con la capacità di assorbire picchi di concorrenza reale.
- Traffico normale: per un volume di 100-200 utenti totali con un uso sporadico o distribuito, questo design è molto efficiente, tollerante ai guasti e terrà sotto controllo i costi.
- Traffico simultaneo: l’istanza
db.m7g.largesupporta fino a 80 utenti che interagiscono contemporaneamente senza degrado delle prestazioni, grazie ai suoi 2 vCPU dedicati (non burstable) e agli 8 GB di RAM. Le ricerche vettoriali di pgvector, le scritture di telemetria di Phoenix e le query sulla memoria conversazionale possono girare in parallelo senza contendersi i crediti CPU. Il livello di calcolo di Fargate scalerà in modo fluido tramite l’Auto Scaling di ECS per assorbire il carico corrispondente. - Oltre 80 utenti simultanei: se la concorrenza sostenuta supera stabilmente questa soglia, il primo passo è spostare Phoenix su un’istanza RDS propria e valutare uno scaling verticale dell’istanza principale a
db.m7g.xlarge(4 vCPU, 16 GB di RAM).
Riepilogo dello stack
Due cluster Fargate (Produzione HA, Sviluppo 50%). Un servizio Fargate per Phoenix. Una funzione Lambda. Un’istanza RDS (Multi-AZ, db.m7g.large, pgvector, quattro funzioni). Un ALB con SSO. GitLab per la CI/CD e il controllo dei deploy. CloudWatch per l’infrastruttura. Route 53 per il failover DNS. DR pilot light multi-regione in us-west-2. Approvazione umana a convalida di ogni modifica in produzione.
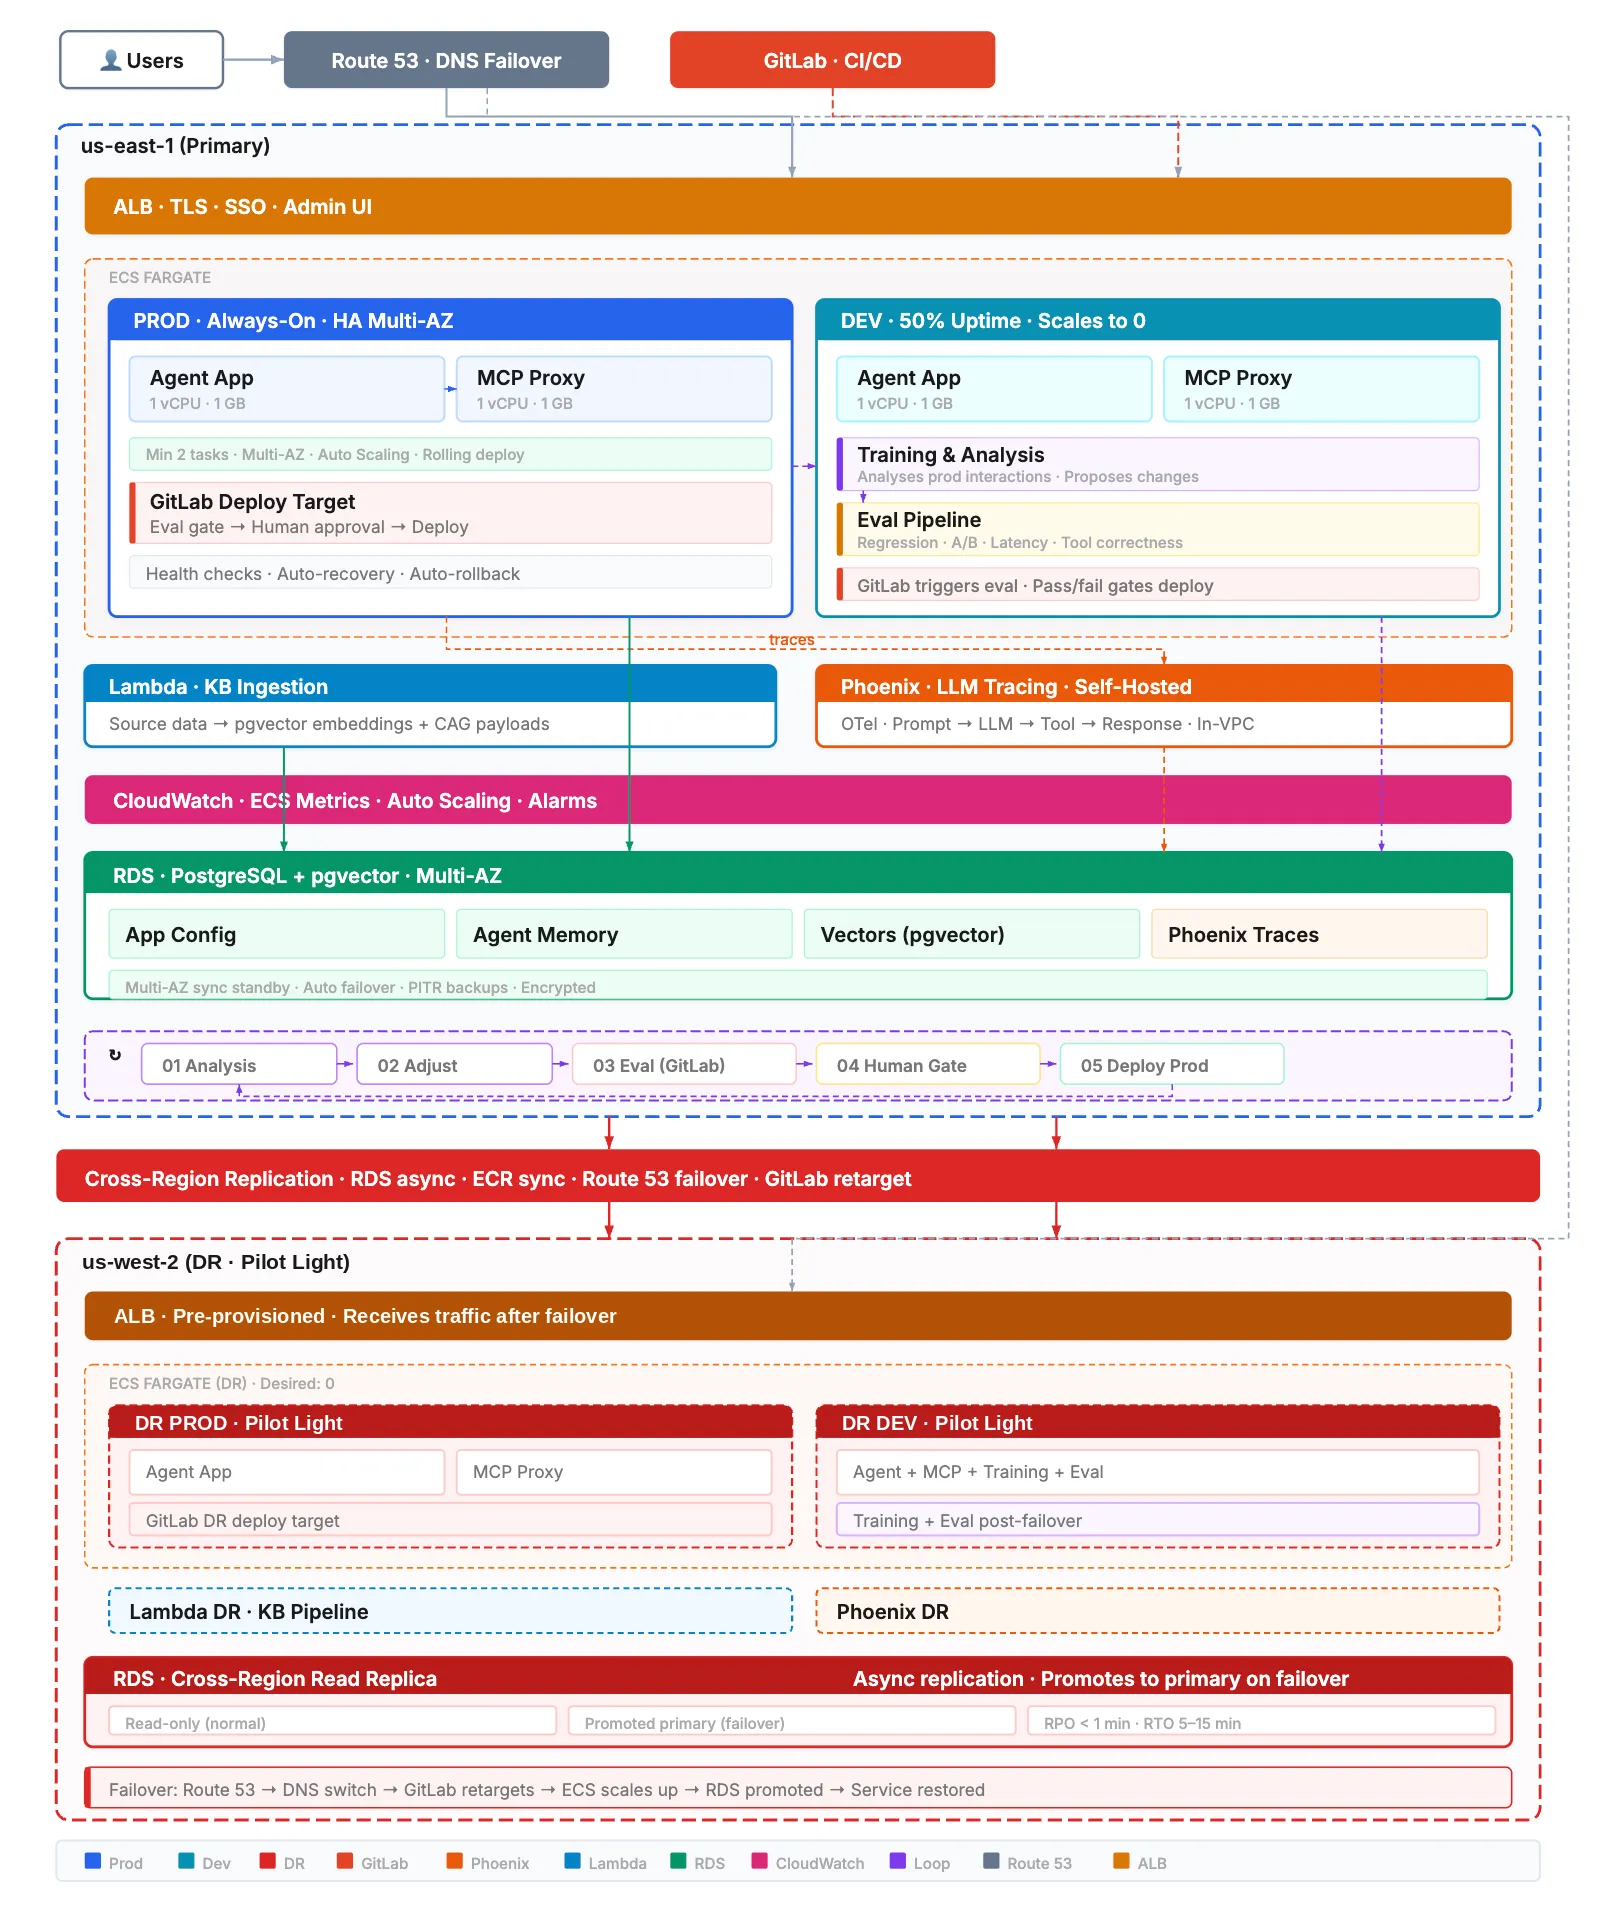
Questo è un modo di costruirla. I componenti sono intercambiabili — pgvector potrebbe essere sostituito da un database vettoriale dedicato se la scala lo richiede, Phoenix potrebbe essere sostituito da un altro strumento di observability compatibile con OTel, e il pilot light potrebbe evolvere in warm standby o in attivo-attivo se lo SLA lo richiede. I principi alla base del design — separazione delle responsabilità, deployment controllati, telemetria self-hosted, miglioramento continuo con supervisione umana — valgono indipendentemente dagli strumenti specifici scelti.

AI Platform Engineer & Full-Stack Developer
Building Enterprise Integrations & Automations
- Che cos'è davvero un LLM — e come misurarlo con Artificial Analysis - 12 settembre 2026
- AI SDLC: una raccolta di buone pratiche per sviluppare con l'IA - 19 giugno 2026
- Agentic Patterns e le molte facce del RAG - 25 maggio 2026