
Architecture d'un agent — Infrastructure en production
Traduit de l'original en espagnol. Lire en espagnol
Cet article détaille une conception possible pour une infrastructure d’agent de niveau production sur AWS.
Il n’existe pas d’architecture unique et correcte pour mettre un agent d’IA en production. La bonne conception dépend de votre échelle, de vos exigences de conformité et de la complexité opérationnelle que vous êtes prêt à assumer. Ce qui suit est une option concrète — pas la seule façon de faire, mais une approche argumentée et de niveau production qui reflète de vraies décisions d’infrastructure.
Compute — AWS ECS Fargate
Deux clusters : production (toujours actif, haute disponibilité) et développement (50 % d’uptime, réduit à zéro en dehors des heures de bureau). Chacun exécute deux services.
- L’application de l’agent gère les appels au LLM, l’orchestration des différents nœuds, la coordination des outils et une interface d’administration. Pour le RAG, elle interroge
pgvector. Pour le CAG, elle charge directement les payloads de contexte complet. Dimensionnée à1 vCPU / 2 GB. - Le proxy MCP abstrait l’orchestration des différents serveurs MCP en acheminant les appels d’outils vers des MCP externes. Il est découplé du runtime de l’agent — on peut ainsi ajouter ou changer des MCP sans refaire un deployment de l’application principale. Également à
1 vCPU / 2 GB.
Haute disponibilité en production
Au minimum deux tâches réparties sur plusieurs zones de disponibilité. Les tâches défaillantes sont désenregistrées et remplacées automatiquement. Les rolling deployments s’exécutent à 100 % minimum en bonne santé / 200 % maximum — zéro interruption de service. L’Auto Scaling ajuste le nombre de tâches en fonction d’objectifs de CPU et de mémoire via CloudWatch.
Cluster de développement
Le cluster de développement ne sert pas seulement de staging. L’entraînement, l’évaluation et les tests d’intégration s’y exécutent dans la même fenêtre de 50 % d’uptime. Pas de tâches planifiées à part, pas de coût de compute supplémentaire. Il est réduit à zéro en dehors des heures de bureau grâce à la planification des services ECS.
CI/CD — GitLab
GitLab pilote tout le pipeline de deployment. Les commits sur la branch de staging déclenchent l’Eval Pipeline dans le cluster de développement. Réussir l’évaluation débloque l’étape de deployment, qui promeut les changements en production via un rolling update ECS. Les changements de prompt, les mises à jour de modèles et les modifications de configuration de l’agent passent tous par le même pipeline — rien n’arrive en production sans avoir d’abord réussi une évaluation automatisée. On part du principe que GitLab fait partie de la plateforme existante : il n’y a donc pas de coût d’infrastructure supplémentaire.
Lors d’un failover de DR, le pipeline GitLab est redirigé vers la région de DR. Même définition de pipeline, mêmes contrôles, cible de deployment différente.
Ingestion de la KB — AWS Lambda
Le pipeline d’ingestion fonctionne en mode serverless. Il transforme les données sources brutes en contenu propre et structuré, écrit les embeddings dans pgvector pour le RAG et prépare les payloads de contexte complet pour le CAG. Coût nul au repos, facturé à l’invocation.
Observability — Arize Phoenix
Phoenix s’exécute comme un service Fargate auto-hébergé, conçu spécifiquement pour l’observability des LLM. Il trace toute la chaîne de l’agent — appels au LLM, exécution des outils via MCP, chemins de récupération et réponses du modèle. Dimensionné à 0.5 vCPU / 1 GB. Il stocke toutes les données de trace dans l’instance RDS PostgreSQL existante — aucune couche de stockage séparée n’est nécessaire.
Toute la télémétrie reste in-VPC. Aucune donnée ne part vers un SaaS tiers.
CloudWatch gère la couche d’infrastructure — métriques ECS, suivi des objectifs d’Auto Scaling et alarmes en cas d’échec de tâches ou de dépassement de seuils RDS. Phoenix gère la chaîne LLM. Les deux se complètent au lieu de se chevaucher.
Stockage — une instance RDS, quatre rôles
Stratégie de stockage : une seule instance RDS
Regrouper la configuration de l’application, la mémoire conversationnelle, le stockage vectoriel et les traces Phoenix sur une seule instance db.m7g.large (2 vCPU, 8 GB de RAM) est un choix qui équilibre le coût et la capacité de charge réelle. Contrairement aux instances burstable de la famille t4g, la m7g.large fournit ses 2 vCPU complets de manière soutenue — pas de crédits CPU, pas de dégradation sous charge continue. C’est essentiel quand les recherches vectorielles de pgvector entrent en concurrence avec les écritures de télémétrie de Phoenix, car ces deux charges sont gourmandes en CPU et peuvent coïncider en situation de concurrence réelle.
- Capacité : avec 2 vCPU dédiés et 8 GB de RAM, cette instance prend confortablement en charge jusqu’à 80 utilisateurs simultanés effectuant en même temps des recherches vectorielles, des écritures de télémétrie et des requêtes de mémoire conversationnelle. Les 8 GB de RAM permettent aussi à pgvector de garder une part importante de l’index vectoriel en mémoire, ce qui réduit la pression sur le disque.
- Critère de mise à l’échelle : si le trafic simultané soutenu dépasse régulièrement 80 utilisateurs, l’étape naturelle suivante consiste à déplacer Phoenix sur sa propre instance (ex.
db.t4g.small— la télémétrie n’est pas sur le chemin critique de la requête, une instance burstable suffit donc) et à envisager une montée en gamme verticale de l’instance principale versdb.m7g.xlarge. Autre option : migrer pgvector vers une base de données vectorielle dédiée si l’index dépasse ce qu’une seule instance PostgreSQL peut servir efficacement.
L’instance PostgreSQL (db.m7g.large, 50 GB gp3) dispose de snapshots quotidiens et d’une standby replica Multi-AZ. En cas de panne, RDS effectue un failover automatique vers la réplique de secours, sans perte de données.
Réseau — ALB avec SSO
Un seul ALB est placé devant l’interface d’administration pour la configuration de l’agent, l’édition des prompts, la gestion des outils et la revue human-in-the-loop. Terminaison TLS et authentification OIDC via Okta, ou tout autre fournisseur d’identité (IdP). L’endpoint de health check de l’ALB est surveillé par Route 53 et sert de déclencheur au failover de DR.
Reprise après sinistre (DR) — pilot light multi-région
Le stack principal tourne dans us-east-1. La région de DR est us-west-2.
La réplication asynchrone inter-régions de RDS alimente une réplique en lecture dans us-west-2. Le retard de réplication est généralement inférieur à une minute, ce qui donne un RPO de moins d’une minute. Lors d’un failover régional, la réplique est promue en base de données principale indépendante et le stack de DR pointe vers elle.
Tous les clusters Fargate de la région de DR fonctionnent avec un nombre souhaité de zéro en fonctionnement normal — aucune tâche ne tourne ; le compute applicatif démarre pendant le failover, tandis que le reste de l’infrastructure de DR reste pré-provisionné. C’est le pattern pilot light. Les images de conteneurs sont disponibles grâce à la réplication inter-régions d’ECR. Les health checks de Route 53 surveillent l’ALB principal. En cas de panne, le DNS bascule vers l’ALB de DR avec un TTL de 60 secondes. GitLab redirige vers us-west-2. ECS fait monter en charge les clusters de DR. Phoenix, dans la région de DR, s’active et pointe vers la réplique promue. Le pipeline Lambda de la KB dans us-west-2 — déjà déployé à l’identique — commence à écrire dans la base promue.
Le RTO de cette configuration est d’environ 15 minutes, selon la rapidité avec laquelle la panne est détectée et la séquence de DR déclenchée. Si le SLA exige un RTO de moins de cinq minutes, les clusters Fargate de DR devraient fonctionner avec un nombre souhaité de un (warm standby) au lieu de zéro, ce qui ajoute environ 72 $ par mois.
Une conception actif-actif multi-région est une architecture complètement différente — elle exige une gestion d’état distribuée et une résolution des conflits pour les écritures RDS. Pour la plupart des charges de travail d’agents, un DR en mode pilot light avec un RTO d’environ 15 minutes est le bon compromis.
La boucle d’amélioration continue
Sans boucle de rétroaction, l’agent dérive. La qualité des prompts se dégrade, les connaissances deviennent obsolètes et personne ne s’en aperçoit avant que les utilisateurs ne se plaignent. Cette boucle s’exécute dans le cluster de développement et soumet chaque changement à une évaluation automatisée et à une validation humaine.
- Analyse des interactions : extraire les journaux de conversation de RDS et les données de trace de Phoenix. Un LLM note la qualité des interactions et fait ressortir les schémas de dégradation — réponses peu sûres, solutions de repli (fallbacks), échecs d’appels d’outils, corrections des utilisateurs, sessions abandonnées.
- Ajustement des prompts et du CAG : proposer des modifications des instructions système, des exemples few-shot, des guardrails et des modèles de prompt. Pour le CAG, déclencher la Lambda de la KB afin de régénérer les payloads de contexte obsolètes. Tous les changements sont versionnés et font l’objet d’un commit sur une branch de staging dans GitLab.
- Évaluation automatisée : GitLab détecte le commit sur staging et déclenche l’Eval Pipeline dans le cluster de développement. Régression sur le golden dataset, comparaison A/B, benchmarks de latence, exactitude des appels d’outils. En cas de réussite — l’étape de deploy est débloquée. En cas d’échec — le pipeline s’arrête.
- Human-in-the-Loop : les résultats de l’évaluation, les diffs et les comparaisons avant/après sont affichés dans l’interface d’administration via l’ALB. Une validation explicite est requise. Sans exception.
- Promotion en production : GitLab exécute le rolling update ECS vers le cluster de production dans
us-east-1. Phoenix surveille les premières heures de trafic. Rollback automatique si une régression est détectée.
Les interactions de production alimentent le cycle suivant. La boucle s’entretient d’elle-même.
Coût mensuel de l’infrastructure
Région principale (us-east-1) :
- Fargate Production (2 services × 2 tâches, 1 vCPU / 2 GB) — $144.16
- Fargate Développement (2 services × 1 tâche, 50 % d’uptime) — $36.04
- Phoenix — $18.02
- Lambda — ~$1.00
- RDS Multi-AZ + pgvector (db.m7g.large, 50 GB gp3) — $256.78
- ALB + CloudWatch + ECR + Secrets — $28.03
- Total principal — ~$484/mois
Région de DR (us-west-2, pilot light) :
- Réplique RDS en lecture inter-régions (db.m7g.large, 50 GB gp3) — $128.39
- ALB pré-provisionné — $16.00
- Health checks Route 53 + routage de failover — $4.00
- Réplication inter-régions ECR — ~$1.00
- Clusters Fargate (souhaité : 0, inactifs) — $0.00
- Phoenix DR + Lambda DR (inactifs) — $0.00
- DR supplémentaire — ~$149/mois
Total avec DR — ~$633/mois
La réplique RDS inter-régions représente l’essentiel du coût du DR. Fargate ne coûte rien tant qu’aucune tâche ne tourne. Activer le compute de DR lors d’un vrai failover ajoute les coûts de Fargate et de Phoenix pour le mois concerné, mais il s’agit de pics ponctuels et non de dépenses continues.
L’écart de coût par rapport à une instance burstable équivalente en Multi-AZ (db.t4g.medium, ~$106/mois stockage compris) est d’environ $150/mois dans la région principale. Ce surcoût élimine entièrement le risque de dégradation lié à l’épuisement des crédits CPU — un compromis justifié quand on a besoin de performances prévisibles sous une concurrence réelle.
Précision sur la capacité de charge
Cette architecture de base, avec son dimensionnement initial (conteneurs Fargate de 1 vCPU / 2 GB et une instance RDS db.m7g.large), est conçue pour une charge faible à modérée, avec la capacité d’absorber de vrais pics de concurrence.
- Trafic normal : pour un volume de 100 à 200 utilisateurs au total, avec un usage ponctuel ou réparti, cette conception est très efficace, tolérante aux pannes et gardera les coûts sous contrôle.
- Trafic simultané : l’instance
db.m7g.largeprend en charge jusqu’à 80 utilisateurs interagissant simultanément sans dégradation des performances, grâce à ses 2 vCPU dédiés (non burstable) et à ses 8 GB de RAM. Les recherches vectorielles de pgvector, les écritures de télémétrie de Phoenix et les requêtes de mémoire conversationnelle peuvent s’exécuter en parallèle sans se disputer des crédits CPU. La couche de calcul Fargate montera en charge de façon fluide grâce à l’Auto Scaling d’ECS pour absorber la charge correspondante. - Au-delà de 80 utilisateurs simultanés : si la concurrence soutenue dépasse régulièrement ce seuil, la première étape consiste à déplacer Phoenix sur sa propre instance RDS et à envisager une montée en gamme verticale de l’instance principale vers
db.m7g.xlarge(4 vCPU, 16 GB de RAM).
Récapitulatif du stack
Deux clusters Fargate (Production HA, Développement 50 %). Un service Fargate pour Phoenix. Une fonction Lambda. Une instance RDS (Multi-AZ, db.m7g.large, pgvector, quatre rôles). Un ALB avec SSO. GitLab pour la CI/CD et le contrôle des déploiements. CloudWatch pour l’infrastructure. Route 53 pour le failover DNS. Un DR pilot light multi-région dans us-west-2. Une validation humaine de chaque changement en production.
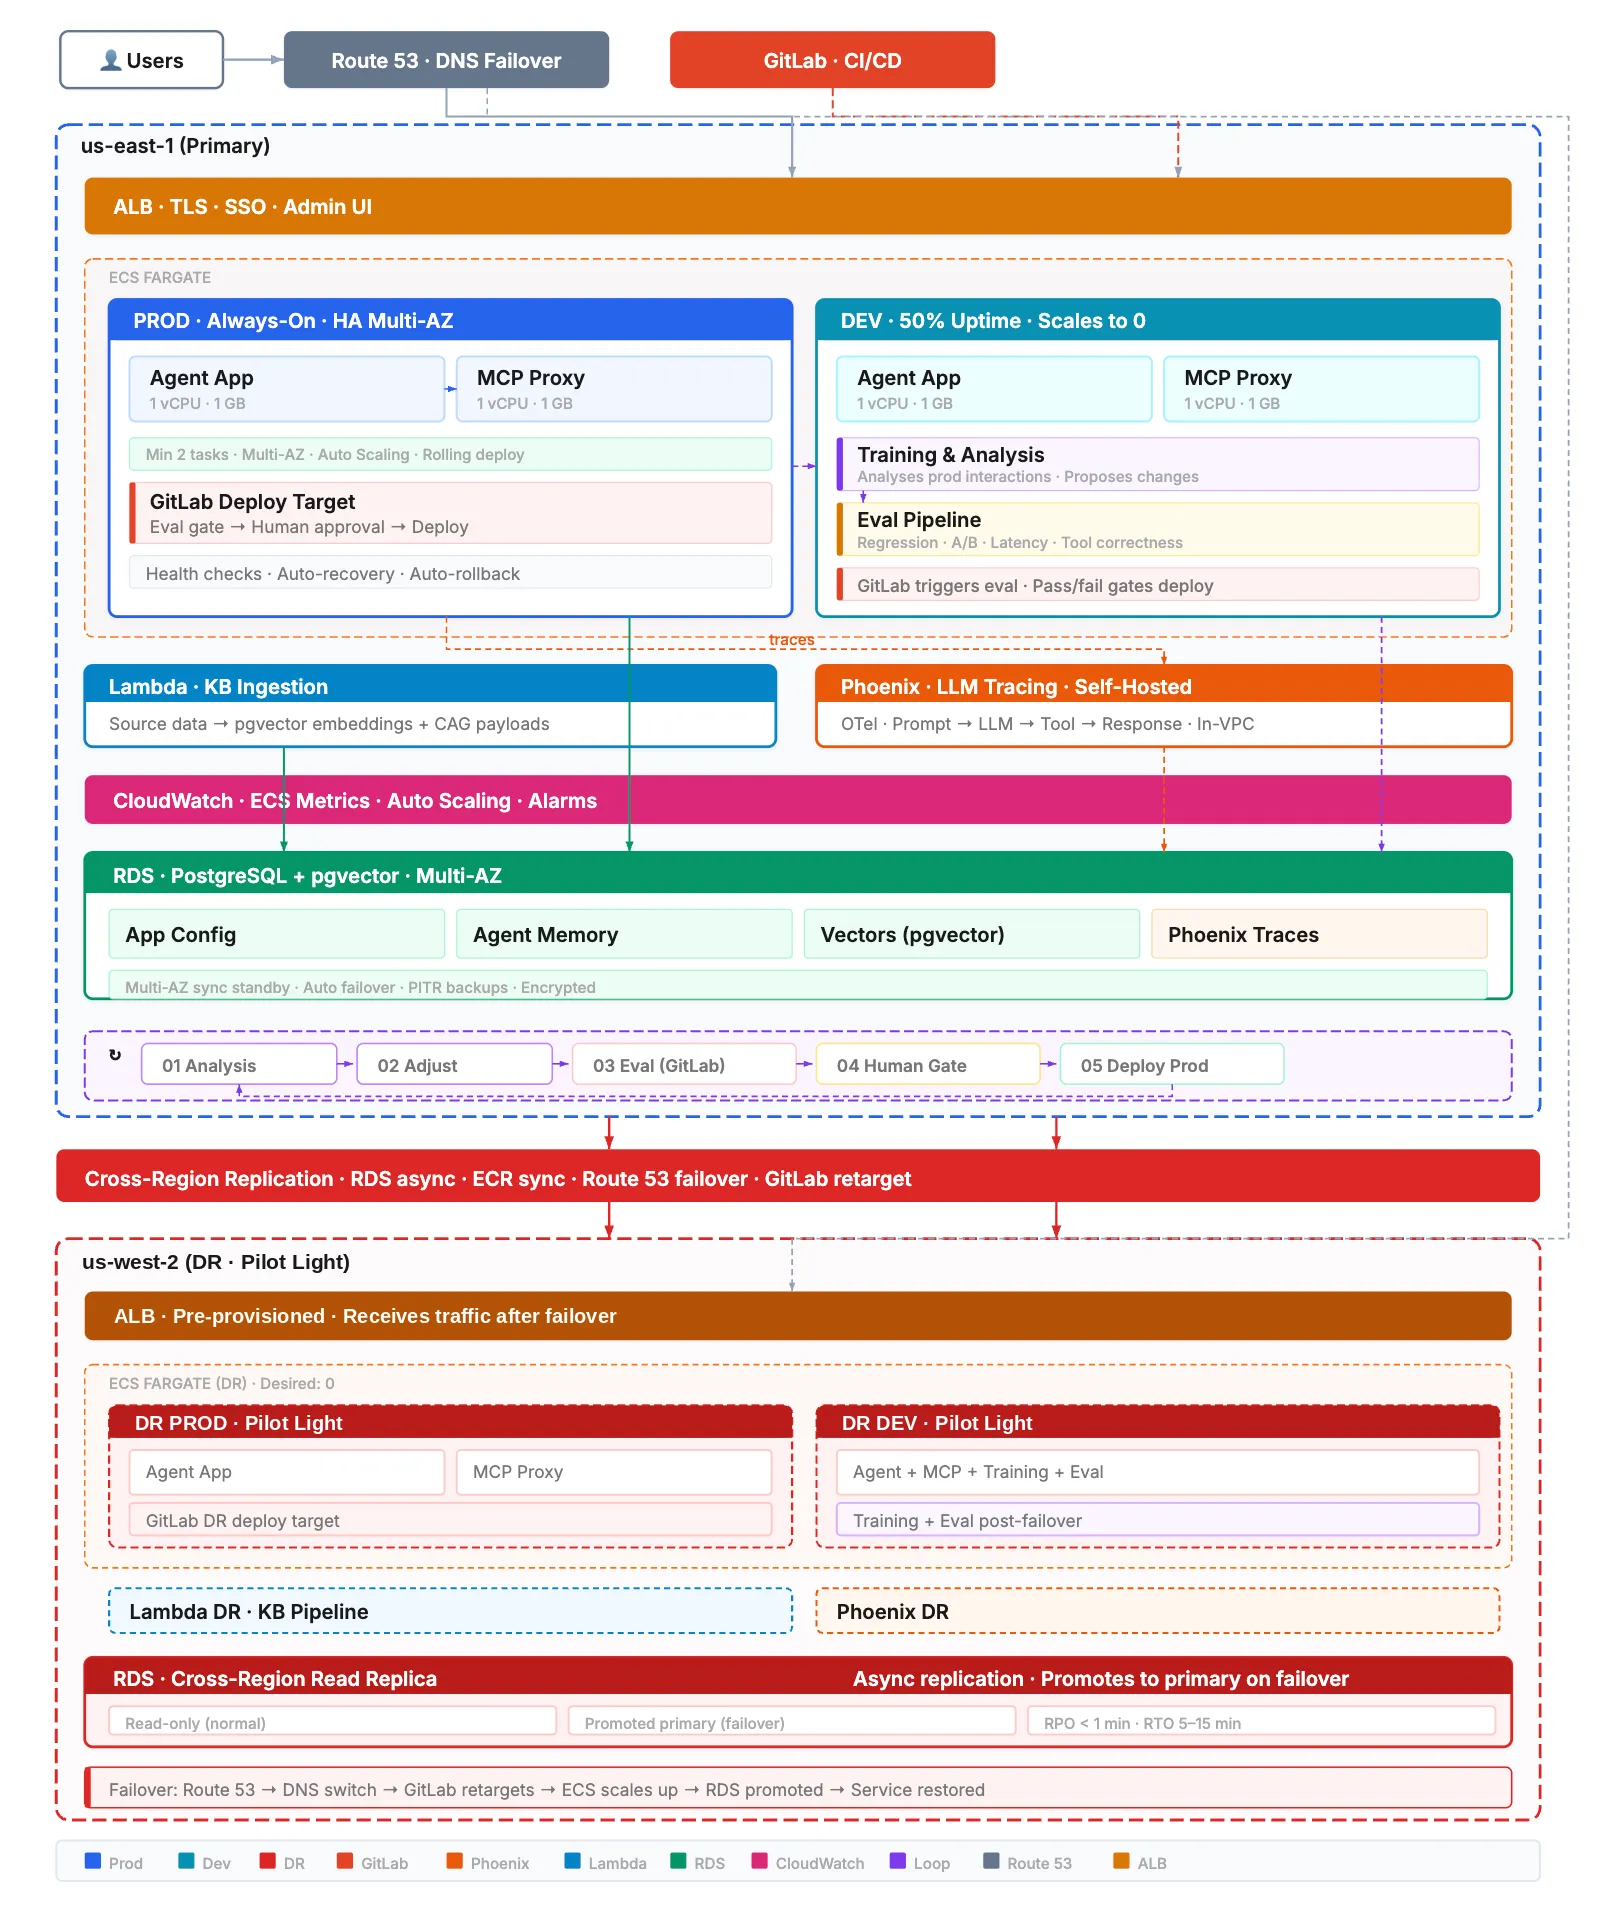
C’est une façon de la construire. Les composants sont interchangeables — pgvector pourrait être remplacé par une base de données vectorielle dédiée si l’échelle l’exige, Phoenix pourrait être remplacé par un autre outil d’observability compatible OTel, et le pilot light pourrait évoluer vers un warm standby ou un actif-actif si le SLA le requiert. Les principes qui sous-tendent la conception — séparation des responsabilités, deployments maîtrisés, télémétrie auto-hébergée, amélioration continue sous supervision humaine — s’appliquent quels que soient les outils choisis.

AI Platform Engineer & Full-Stack Developer
Building Enterprise Integrations & Automations
- Ce qu'est vraiment un LLM — et comment le mesurer avec Artificial Analysis - 12 septembre 2026
- AI SDLC : un recueil de bonnes pratiques pour développer avec l'IA - 19 juin 2026
- Agentic Patterns et les multiples visages du RAG - 25 mai 2026