
Agentic Patterns et les multiples visages du RAG
Traduit de l'original en espagnol. Lire en espagnol
Quand on commence à créer des applications propulsées par l’IA, tout paraît simple : un prompt, un modèle, une réponse. Et ça marche — jusqu’au jour où ça ne marche plus. Jusqu’à ce que le modèle hallucine au lieu de chercher, choisisse le mauvais outil avec une assurance enviable, ou traite une question complexe exactement comme une question triviale.
Ce qu’il vous faut ensuite, ce n’est plus un prompt. C’est un pattern — une façon récurrente de brancher un LLM sur un système pour qu’il se comporte de manière prévisible face aux entrées du monde réel.
J’ai réuni une référence animée de ces patterns sur agents.zerogap.uk. Cet article en est le complément écrit.
Commencez par le Single Agent
Le point de départ que je recommande est le plus simple : un modèle avec un system prompt et un ensemble défini d’outils. L’agent lit la demande de l’utilisateur, décide quel outil appeler, l’appelle et synthétise une réponse.
Vous n’avez besoin de rien de plus élaboré tant que le single agent suffit. Les signaux sont concrets : il hallucine au lieu de chercher l’information, choisit le mauvais outil avec assurance, ou répond de la même manière aux questions rapides et aux questions lentes (mal, pour l’une des deux).
Ce dernier symptôme, c’est ce que corrige le pattern router gate. Un classifieur léger se place à l’entrée du système et décide : cette question va au single agent, celle-là va vers un pipeline multi-étapes plus lourd.
Le RAG n’est pas un pattern — c’est une famille
La raison la plus fréquente pour laquelle un single agent ne suffit pas, c’est que la réponse se trouve dans vos documents, pas dans les poids du modèle. C’est là qu’intervient le Retrieval-Augmented Generation (RAG).
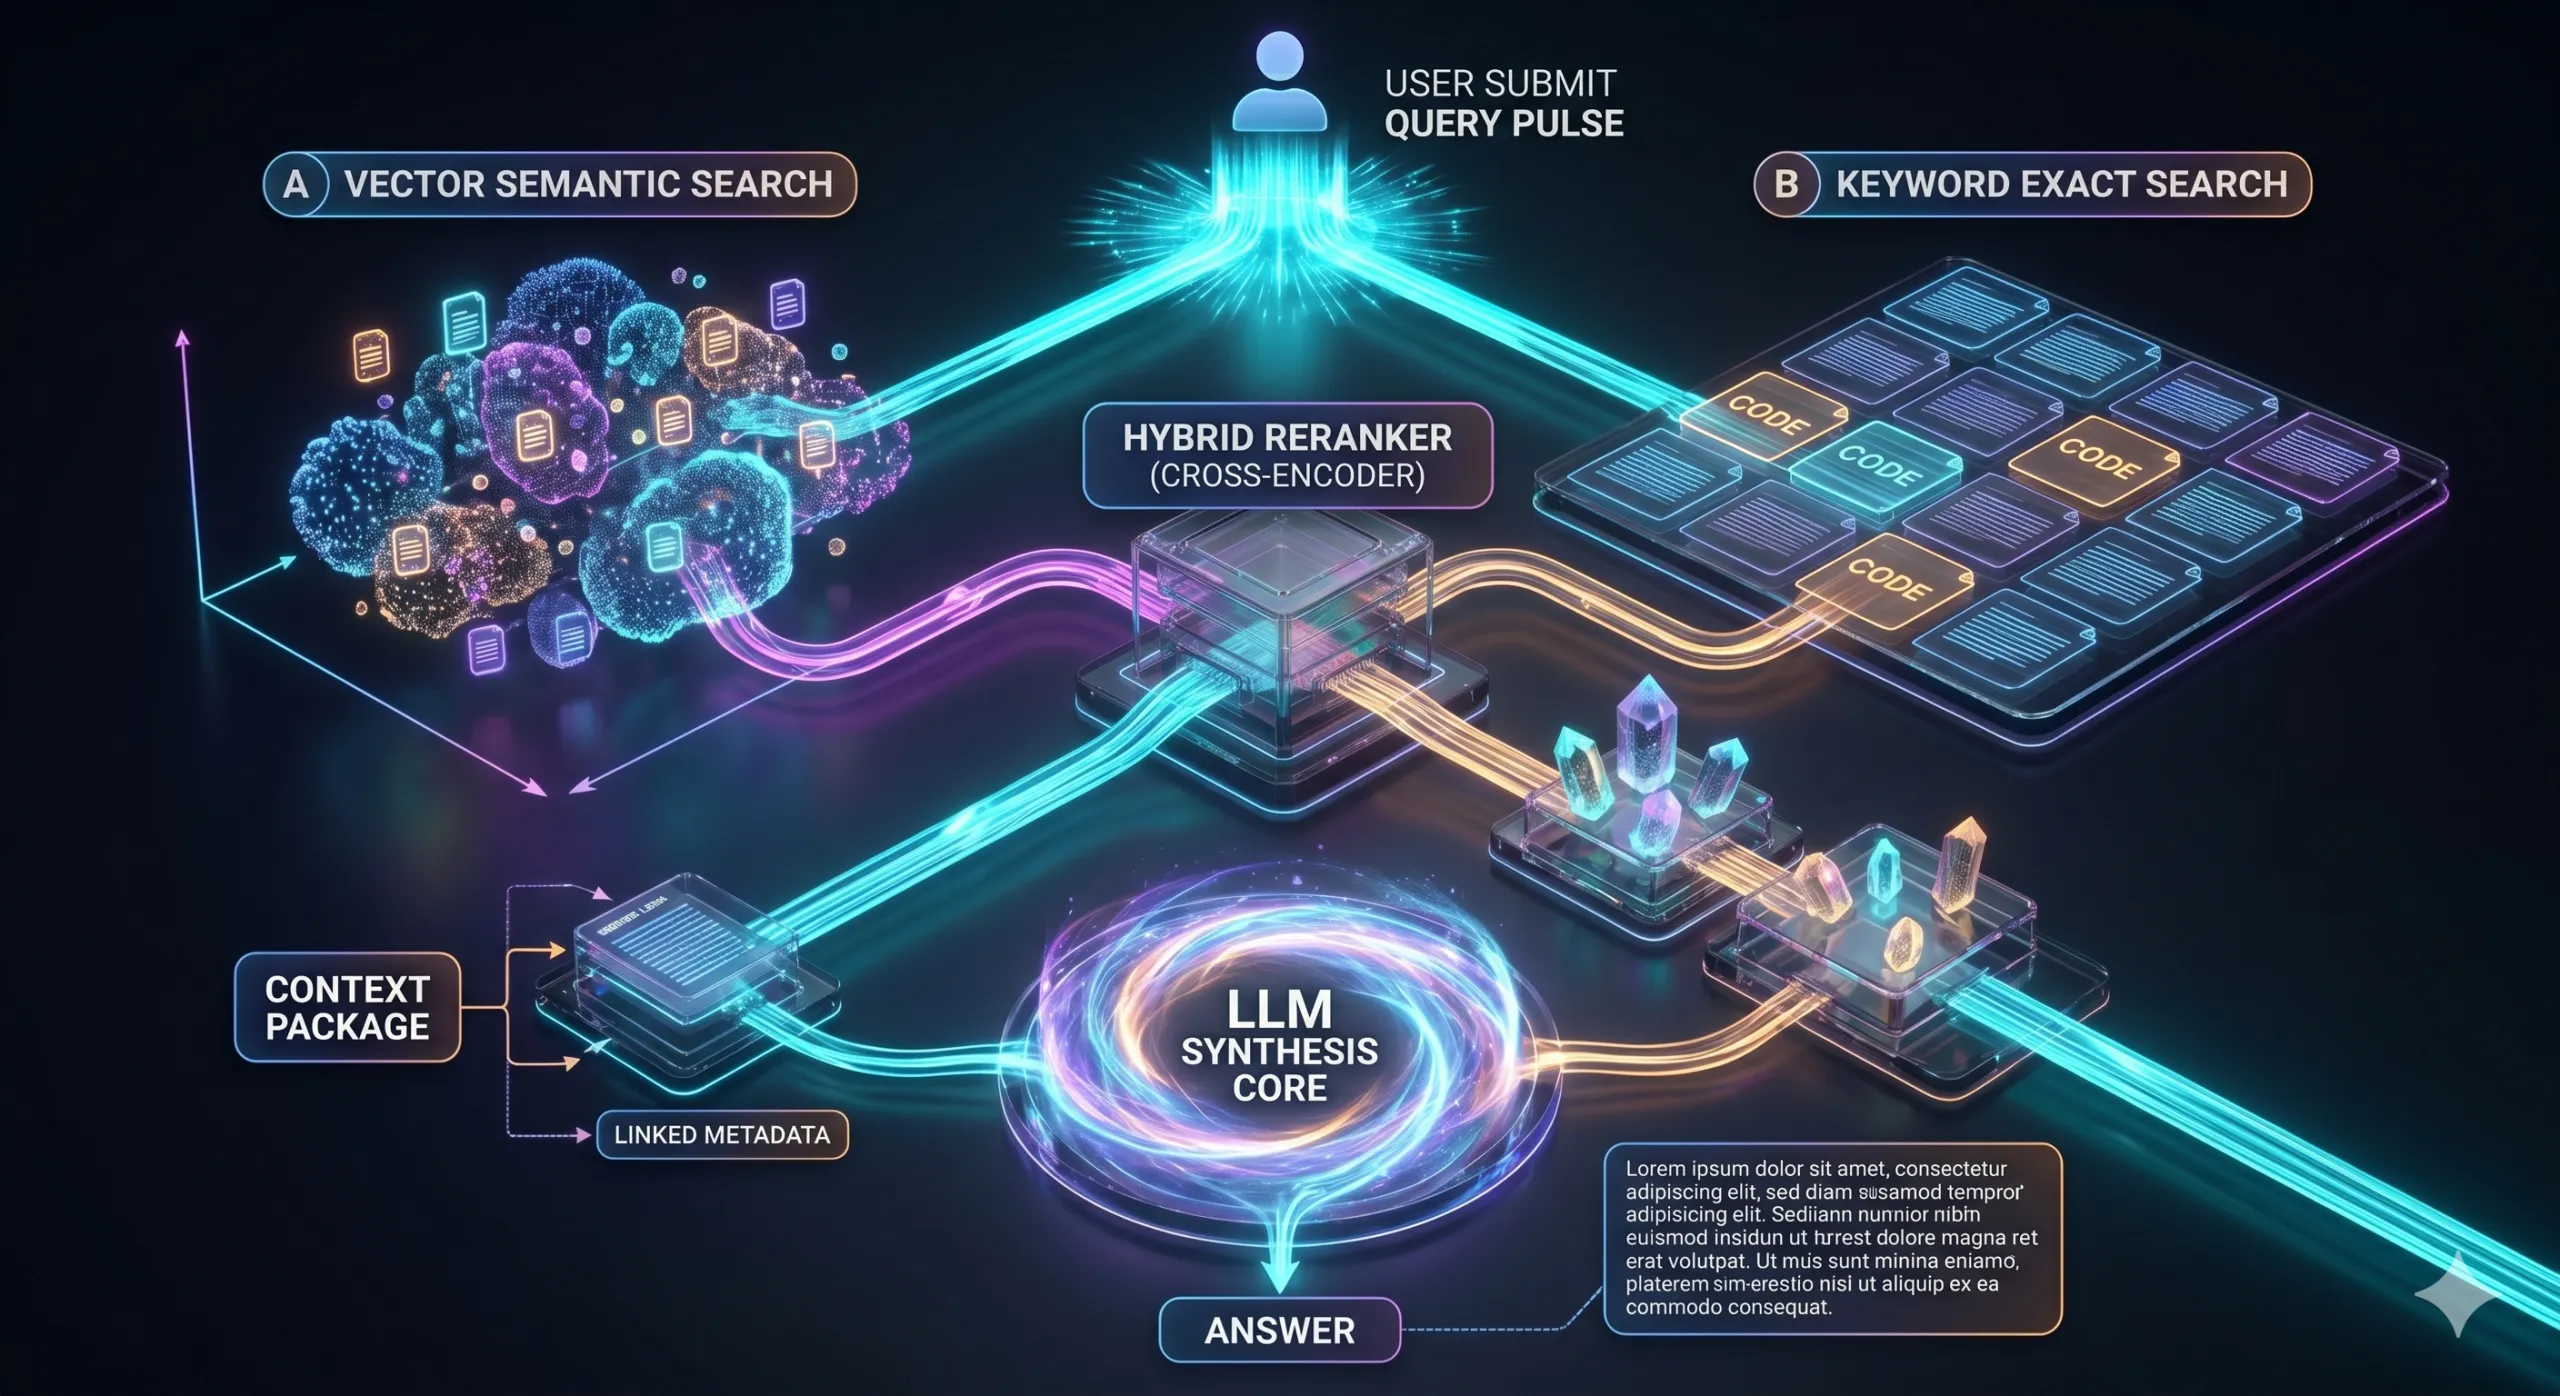
Naive RAG. On calcule l’embedding de la requête, on cherche les chunks les plus proches par similarité cosinus, on les injecte dans le prompt. On le trouve dans tous les tutoriels. Il fonctionne quand le corpus est petit et bien rédigé. Il échoue quand les utilisateurs posent des questions sur des identifiants exacts, des codes ou du jargon — la similarité vectorielle les lisse.
Keyword RAG. BM25 ou une recherche lexicale similaire. Le mode d’échec inverse : excellent pour les requêtes à correspondance exacte (« error code TRX-4012 »), moins bon pour comprendre l’intention.
Hybrid RAG. On exécute les deux et on les combine. Presque toujours meilleur en production que chacun des deux seul.
Reranking RAG. On récupère une première passe large, puis on fait passer un cross-encoder reranker sur les meilleurs candidats. Le reranker lit la requête et le document ensemble et capte la pertinence que la similarité d’embeddings a manquée.
Agentic RAG. L’agent décide s’il faut récupérer, quoi récupérer et quand s’arrêter. Le retrieval devient un outil que le modèle peut appeler à plusieurs reprises. Plus lent, mais il gère les questions multi-hop que le Naive RAG ne sait pas traiter.
Corrective RAG (CRAG). L’agent récupère, puis évalue ce qu’il a récupéré. Si le contexte est faible, il reformule la requête, se rabat sur une recherche web ou refuse de répondre.
Graph RAG. On récupère depuis un knowledge graph au lieu de (ou en plus de) chunks vectoriels. Quand les relations comptent — qui rend compte à qui, quels produits dépendent de quels fournisseurs — le parcours du graphe donne des réponses que la simple similarité de chunks ne peut pas reconstituer.
Tree-Index RAG (Vectorless). Des résumés hiérarchiques. Les gros documents sont résumés à plusieurs niveaux ; le retrieval peut aboutir à un chunk feuille ou remonter vers un résumé de section. Utile quand les context windows sont serrées.
CAG (Cache-Augmented Generation). Quand votre corpus tient dans la context window d’un modèle à long contexte, sautez le retrieval et chargez tout avec le prompt caching. C’est souvent la bonne réponse pour des domaines étroits avec des bases de connaissances stables. Moins cher qu’on ne le pense une fois le caching activé.
L’arbre de décision n’est pas « lequel est le meilleur » — c’est « quel mode d’échec est-ce que j’essaie d’éviter ». Choisissez le plus simple qui passe votre requête la plus difficile, puis ajoutez de la complexité quand une vraie requête le met en échec.
Orchestration : quand un seul agent ne suffit pas
Au-delà du retrieval, la famille de patterns suivante porte sur la façon dont plusieurs étapes ou plusieurs agents se connectent entre eux.
- Sequential — agent A → agent B → agent C. La sortie de chaque étape alimente la suivante.
- Parallel — on répartit des sous-tâches indépendantes, puis on combine les résultats.
- Conditional — on bifurque selon la sortie d’une étape précédente. Du control flow classique appliqué aux appels de LLM.
- Review-and-critique — un agent produit, un autre relit, le premier corrige. Plus lent, mais la qualité monte de façon constante.
- Coordinator — un agent gestionnaire délègue à des spécialistes et assemble leur travail. La forme classique de « l’équipe d’experts ».
- Hierarchical decomposition — on découpe une grande tâche en sous-tâches, chacune pouvant être découpée à son tour.
- Dynamic prompting — le prompt est construit au runtime à partir du contexte de l’utilisateur, des faits récupérés et des tours précédents. Moins un pattern qu’une discipline : arrêtez de coder vos prompts en dur.
- Swarm — de nombreux agents légers en parallèle, avec une coordination minimale.
Voyez-les en mouvement
Ces patterns s’assimilent plus facilement quand on peut les voir. Chacun d’eux sur agents.zerogap.uk est animé : vous voyez la requête circuler jusqu’à l’agent, les tool calls se déclencher, le retrieval se produire, la critique revenir.
Si vous construisez avec des LLM et vous êtes déjà demandé de quel pattern votre problème a vraiment besoin — allez-y et jouez. Les animations rendent les compromis évidents d’une façon que les schémas seuls n’atteignent jamais tout à fait.

AI Platform Engineer & Full-Stack Developer
Building Enterprise Integrations & Automations
- Ce qu'est vraiment un LLM — et comment le mesurer avec Artificial Analysis - 12 septembre 2026
- AI SDLC : un recueil de bonnes pratiques pour développer avec l'IA - 19 juin 2026
- Agentic Patterns et les multiples visages du RAG - 25 mai 2026