
Arquitetura de um agente — infraestrutura em produção
Traduzido do original em espanhol. Ler em espanhol
Este artigo detalha um design possível para uma infraestrutura de agente de nível de produção na AWS.
Não existe uma única arquitetura correta para implementar um agente de IA em produção. O design adequado depende da sua escala, dos requisitos de conformidade e de quanta complexidade operacional você está disposto a suportar. O que segue é uma opção concreta — não a única forma, mas uma abordagem fundamentada e de nível de produção que reflete decisões reais de infraestrutura.
Compute — AWS ECS Fargate
Dois clusters: produção (sempre ativo, alta disponibilidade) e desenvolvimento (50% de uptime, escala a zero fora do horário comercial). Cada um executa dois serviços.
- A aplicação do agente cuida das chamadas ao LLM, da orquestração dos diferentes nós, da coordenação de ferramentas e de uma interface administrativa. Para RAG, consulta o
pgvector. Para CAG, carrega diretamente os payloads de contexto completo. Dimensionada em1 vCPU / 2 GB. - O proxy MCP abstrai a orquestração dos diferentes servidores MCP, encaminhando chamadas de ferramentas para MCPs externos. Desacoplado do runtime do agente — permite adicionar ou trocar MCPs sem precisar fazer um novo deployment da aplicação principal. Também em
1 vCPU / 2 GB.
Alta disponibilidade em produção
No mínimo duas tarefas distribuídas em várias Zonas de Disponibilidade. As tarefas não saudáveis são desregistradas e substituídas automaticamente. Os rolling deployments rodam com 100% mínimo saudável / 200% máximo — zero tempo de inatividade. O Auto Scaling ajusta a quantidade de tarefas com base em metas de CPU e memória via CloudWatch.
Cluster de desenvolvimento
O cluster de desenvolvimento faz mais do que servir de staging. Treinamento, avaliação e testes de integração rodam aqui, dentro da mesma janela de 50% de uptime. Sem tarefas agendadas separadamente, sem custo extra de compute. Escala a zero fora do horário por meio do agendamento de serviços do ECS.
CI/CD — GitLab
O GitLab conduz todo o pipeline de deployment. Os commits na branch de staging disparam o Eval Pipeline no cluster de desenvolvimento. Passar na avaliação libera a etapa de deployment, que promove as mudanças para produção por meio de um rolling update do ECS. Mudanças no prompt, atualizações de modelos e mudanças na configuração do agente passam todas pelo mesmo pipeline — nada chega à produção sem antes passar por uma avaliação automatizada. Supomos que o GitLab faz parte da plataforma existente, então não há custo adicional de infraestrutura.
Em um evento de failover de DR, o pipeline do GitLab é redirecionado para a região de DR. Mesma definição de pipeline, mesmas validações, destino de deployment diferente.
Ingestão da KB — AWS Lambda
O pipeline de ingestão roda em modo serverless. Converte dados de origem brutos em conteúdo limpo e estruturado, gravando os embeddings no pgvector para RAG e preparando payloads de contexto completo para CAG. Custo zero em repouso, cobrado por invocação.
Observability — Arize Phoenix
O Phoenix roda como um serviço Fargate autohospedado e feito especificamente para a observability de LLM. Ele rastreia toda a cadeia do agente — chamadas ao LLM, execução de ferramentas via MCP, caminhos de recuperação e respostas do modelo. Dimensionado em 0.5 vCPU / 1 GB. Armazena todos os dados de trace na instância existente de RDS PostgreSQL — não é necessária uma camada de armazenamento separada.
Toda a telemetria fica in-VPC. Nenhum dado sai para um SaaS de terceiros.
O CloudWatch cuida da camada de infraestrutura — métricas do ECS, acompanhamento das metas de Auto Scaling e alarmes para falhas de tarefas ou limites do RDS. O Phoenix cuida da cadeia do LLM. Os dois se complementam em vez de se sobrepor.
Armazenamento — uma instância RDS, quatro funções
Estratégia de armazenamento: uma única instância RDS
Consolidar a configuração da aplicação, a memória conversacional, o armazenamento vetorial e os traces do Phoenix em uma única instância db.m7g.large (2 vCPU, 8 GB de RAM) é uma decisão que equilibra custo e capacidade real de carga. Ao contrário das instâncias burstable da família t4g, a m7g.large entrega seus 2 vCPUs completos de forma sustentada — sem créditos de CPU, sem degradação sob carga contínua. Isso é crítico quando as buscas vetoriais do pgvector competem com as gravações de telemetria do Phoenix, já que ambas as cargas são intensivas em CPU e podem coincidir sob concorrência real.
- Capacidade: Com 2 vCPUs dedicados e 8 GB de RAM, esta instância suporta com folga até 80 usuários simultâneos executando buscas vetoriais, gravações de telemetria e consultas de memória conversacional ao mesmo tempo. Os 8 GB de RAM também permitem que o pgvector mantenha uma parte significativa do índice vetorial em memória, reduzindo a pressão sobre o disco.
- Critério de escalabilidade: Se o tráfego simultâneo sustentado superar consistentemente os 80 usuários, o próximo passo natural é separar o Phoenix em uma instância própria (ex.:
db.t4g.small— a telemetria não está no caminho crítico da requisição, então uma instância burstable basta) e considerar um escalonamento vertical da instância principal paradb.m7g.xlarge. Como alternativa, migrar o pgvector para um banco de dados vetorial dedicado se o índice crescer além do que uma única instância PostgreSQL consegue servir com eficiência.
A instância PostgreSQL (db.m7g.large, 50 GB gp3) conta com snapshots diários e uma standby replica Multi-AZ. Em caso de falha, o RDS faz o failover automático para a réplica de reserva, sem perda de dados.
Redes — ALB com SSO
Um único ALB fica na frente da interface de administração para configuração do agente, edição de prompts, administração de ferramentas e revisão human-in-the-loop. Terminação TLS e autenticação OIDC por meio do Okta ou de qualquer outro provedor de identidade (IdP). O endpoint de health check do ALB é monitorado pelo Route 53 como gatilho do failover de DR.
Recuperação de desastres (DR) — pilot light multirregião
O stack principal roda em us-east-1. A região de DR é us-west-2.
A replicação assíncrona do RDS entre regiões alimenta uma réplica de leitura em us-west-2. O atraso de replicação costuma ficar abaixo de um minuto, o que dá um RPO de menos de um minuto. Em um failover regional, a réplica é promovida a banco de dados principal independente e o stack de DR passa a apontar para ela.
Todos os clusters Fargate na região de DR operam com contagem desejada zero em operação normal — não há tarefas rodando; o compute da aplicação é iniciado durante o failover, enquanto o resto da infraestrutura de DR permanece pré-provisionado. Esse é o padrão pilot light. As imagens de contêiner ficam disponíveis por meio da replicação entre regiões do ECR. Os health checks do Route 53 monitoram o ALB principal. Em caso de falha, o DNS muda para o ALB de DR com TTL de 60 segundos. O GitLab redireciona para us-west-2. O ECS escala os clusters de DR. O Phoenix na região de DR é ativado e aponta para a réplica promovida. O pipeline Lambda da KB em us-west-2 — já implantado de forma idêntica — começa a gravar no banco de dados promovido.
O RTO com essa configuração é de aproximadamente 15 minutos, dependendo da rapidez com que a falha é detectada e a sequência de DR é disparada. Se o SLA exigir um RTO de menos de cinco minutos, os clusters Fargate de DR deveriam operar com contagem desejada de um (warm standby) em vez de zero, o que acrescenta cerca de US$ 72 por mês.
O design ativo-ativo multirregião é uma arquitetura completamente diferente — exige gerenciamento de estado distribuído e resolução de conflitos para as gravações no RDS. Para a maioria das cargas de trabalho de agentes, o DR em modo pilot light com um RTO de aproximadamente 15 minutos é o equilíbrio adequado.
O ciclo de melhoria contínua
Sem um ciclo de feedback, o agente se desvia. A qualidade do prompt se degrada, o conhecimento fica obsoleto e ninguém percebe até os usuários reclamarem. Este ciclo roda no cluster de desenvolvimento e protege cada mudança por trás de uma avaliação automatizada e de aprovação humana.
- Análise das interações: Extrai os registros de conversa do RDS e os dados de trace do Phoenix. Um LLM classifica a qualidade das interações e revela padrões de degradação — respostas de baixa confiança, fallbacks, falhas em chamadas de ferramentas, correções de usuários, sessões abandonadas.
- Ajuste de prompt e CAG: Propõe mudanças nas instruções do sistema, exemplos few-shot, guardrails e templates de prompt. Para CAG, aciona a Lambda da KB para regenerar payloads de contexto obsoletos. Todas as mudanças são versionadas e recebem commit em uma branch de staging no GitLab.
- Avaliação automatizada: O GitLab detecta o commit em staging e dispara o Eval Pipeline no cluster de desenvolvimento. Regressão do golden dataset, comparação A/B, benchmarks de latência, correção das chamadas de ferramentas. Se passar — a etapa de deploy é liberada. Se falhar — o pipeline para.
- Human-in-the-Loop: Os resultados da avaliação, os diffs e as comparações de antes/depois são exibidos na interface de administração via ALB. É necessária aprovação explícita. Sem exceções.
- Promoção para produção: O GitLab executa o rolling update do ECS para o cluster de produção em
us-east-1. O Phoenix monitora as primeiras horas de tráfego. Rollback automático se for detectada uma regressão.
As interações de produção alimentam o ciclo seguinte. O ciclo se sustenta sozinho.
Custo mensal de infraestrutura
Região principal (us-east-1):
- Fargate Produção (2 serviços × 2 tarefas, 1 vCPU / 2 GB) — $144.16
- Fargate Desenvolvimento (2 serviços × 1 tarefa, 50% de uptime) — $36.04
- Phoenix — $18.02
- Lambda — ~$1.00
- RDS Multi-AZ + pgvector (db.m7g.large, 50 GB gp3) — $256.78
- ALB + CloudWatch + ECR + Secrets — $28.03
- Total principal — ~$484/mês
Região de DR (us-west-2, pilot light):
- Réplica de leitura RDS entre regiões (db.m7g.large, 50 GB gp3) — $128.39
- ALB pré-provisionado — $16.00
- Health checks do Route 53 + roteamento de failover — $4.00
- Replicação do ECR entre regiões — ~$1.00
- Clusters Fargate (desejado: 0, ocioso) — $0.00
- Phoenix DR + Lambda DR (ocioso) — $0.00
- DR adicional — ~$149/mês
Total com DR — ~$633/mês
A réplica do RDS entre regiões representa a maior parte do custo de DR. O Fargate não gera custo enquanto não houver tarefas rodando. Ativar o compute de DR em um failover real acrescenta os custos de Fargate e Phoenix naquele mês, mas são picos pontuais, e não gastos contínuos.
A diferença de custo em relação a uma instância burstable equivalente em Multi-AZ (db.t4g.medium, ~$106/mês incluindo armazenamento) é de aproximadamente $150/mês na região principal. Esse aumento elimina por completo o risco de degradação por esgotamento dos créditos de CPU — um trade-off justificado quando se precisa de desempenho previsível sob concorrência real.
Esclarecimento sobre a capacidade de carga
Esta arquitetura base, com seu dimensionamento inicial (contêineres Fargate de 1 vCPU / 2 GB e uma instância RDS db.m7g.large), foi projetada para uma carga baixa a moderada, com capacidade de absorver picos de concorrência real.
- Tráfego normal: Para um volume de 100 a 200 usuários no total, com uso esporádico ou distribuído, este design é altamente eficiente, tolerante a falhas e manterá os custos sob controle.
- Tráfego simultâneo: A instância
db.m7g.largesuporta até 80 usuários interagindo ao mesmo tempo sem degradação de desempenho, graças aos seus 2 vCPUs dedicados (não burstable) e 8 GB de RAM. As buscas vetoriais do pgvector, as gravações de telemetria do Phoenix e as consultas de memória conversacional podem rodar em paralelo sem competir por créditos de CPU. A camada de cômputo do Fargate escalará de forma fluida por meio do Auto Scaling do ECS para absorver a carga correspondente. - Além de 80 simultâneos: Se a concorrência sustentada superar consistentemente esse limite, o primeiro passo é separar o Phoenix em uma instância RDS própria e considerar um escalonamento vertical da instância principal para
db.m7g.xlarge(4 vCPU, 16 GB de RAM).
Resumo do stack
Dois clusters Fargate (Produção HA, Desenvolvimento 50%). Um serviço Fargate para o Phoenix. Uma função Lambda. Uma instância RDS (Multi-AZ, db.m7g.large, pgvector, quatro funções). Um ALB com SSO. GitLab para CI/CD e controle de deploys. CloudWatch para infraestrutura. Route 53 para failover de DNS. DR pilot light multirregião em us-west-2. Aprovação humana validando cada mudança em produção.
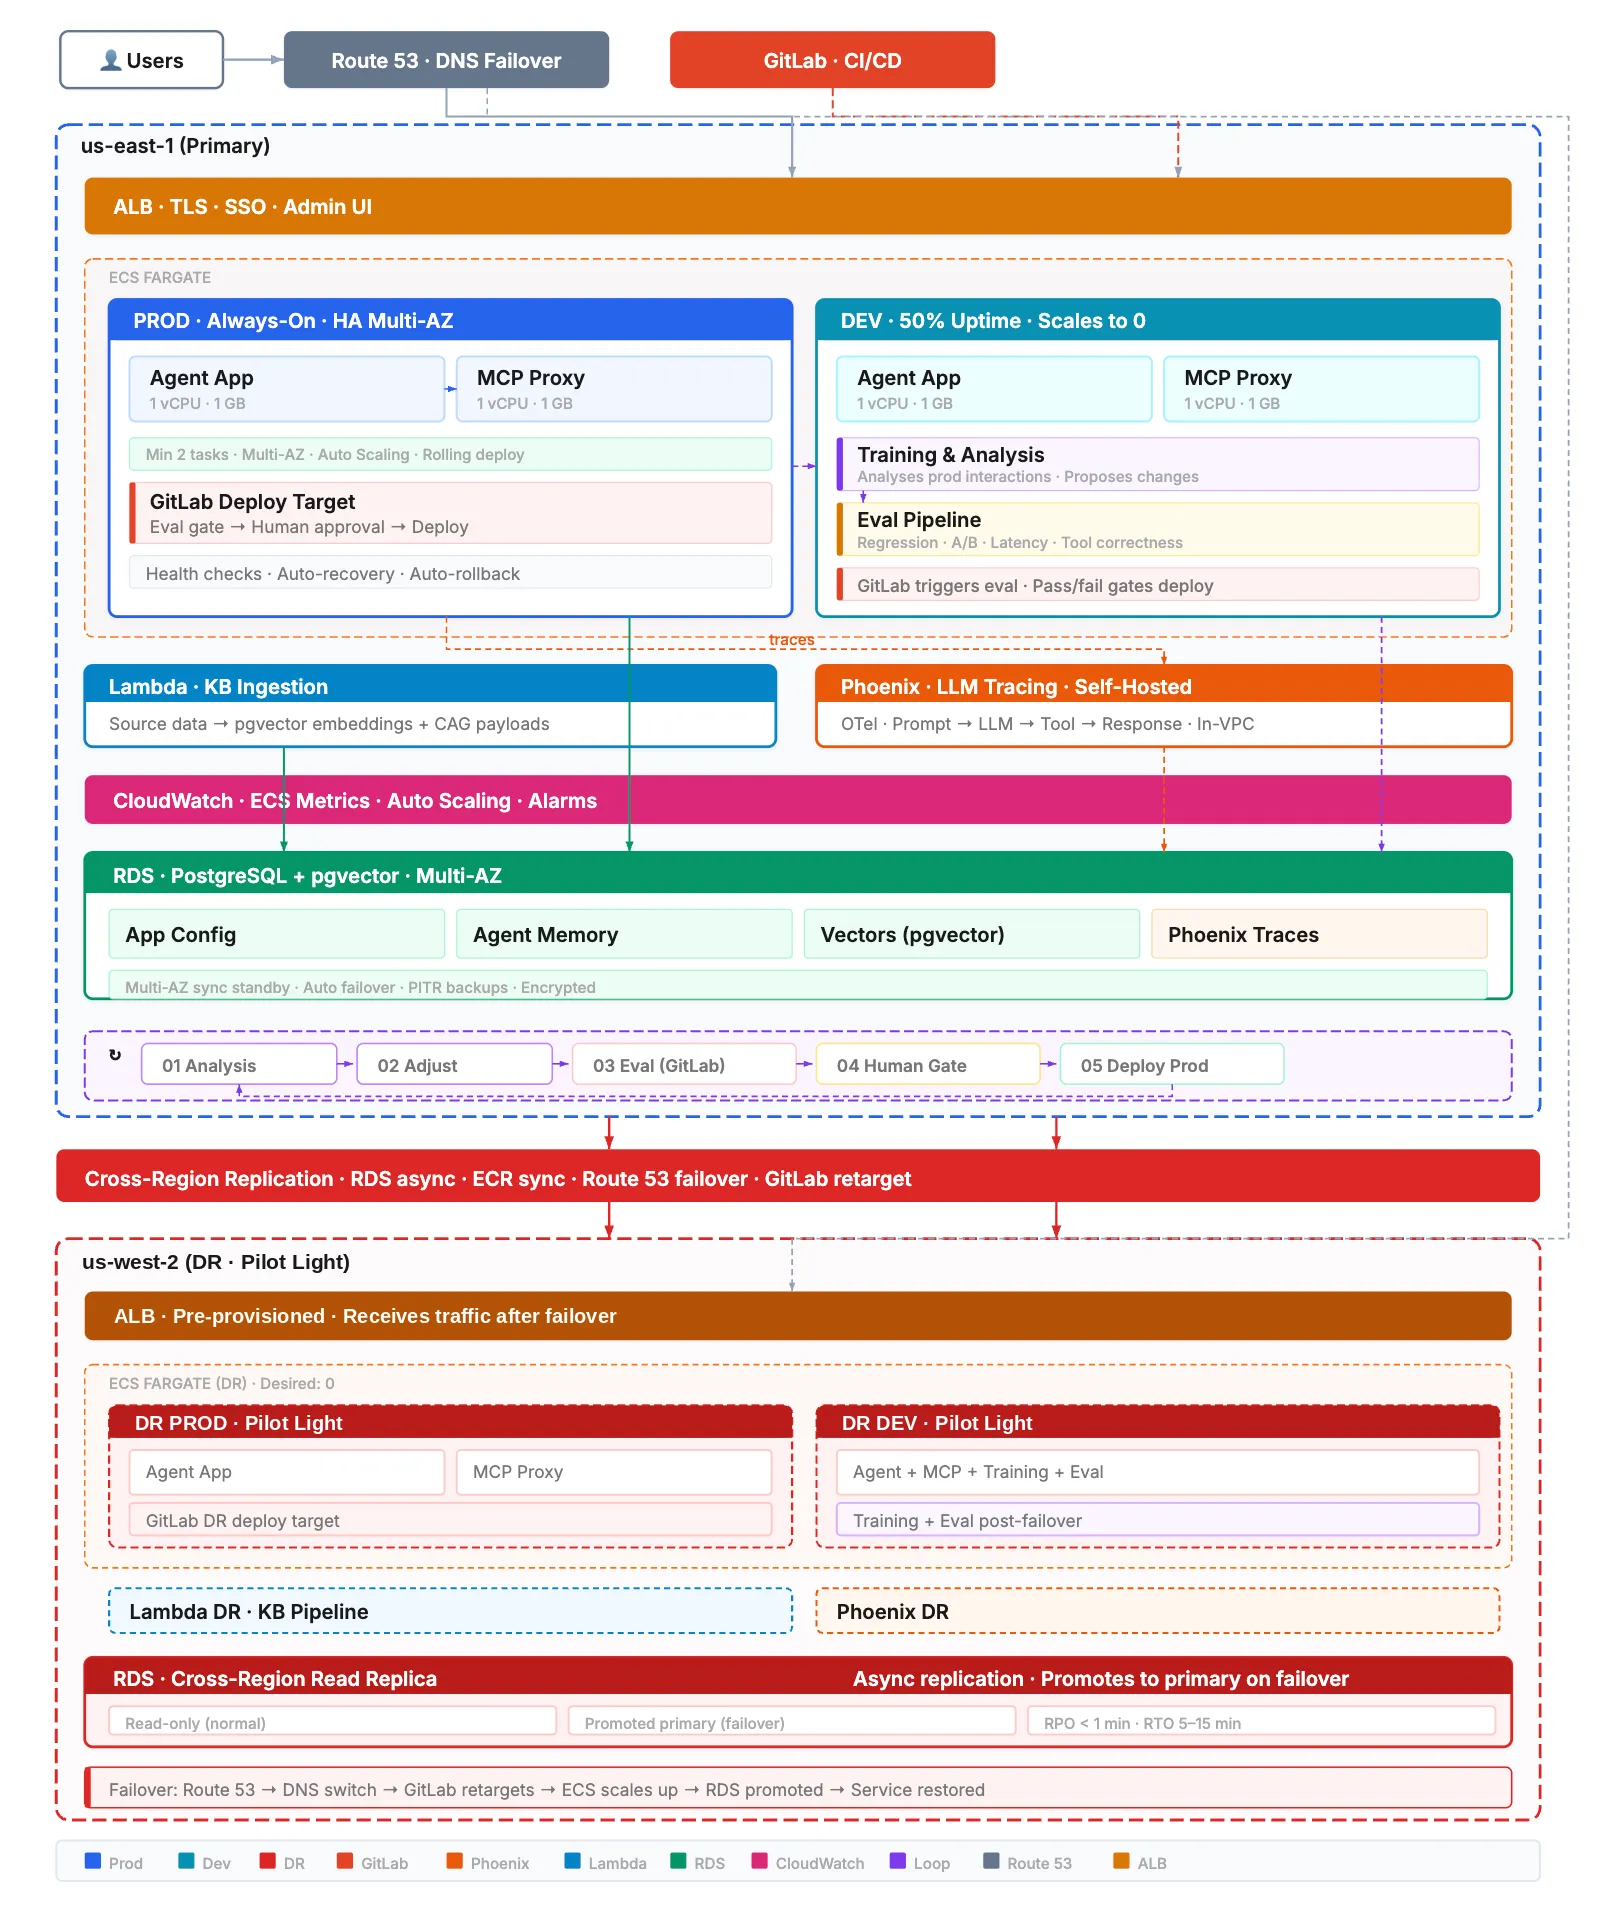
Esta é uma forma de construir. Os componentes são intercambiáveis — o pgvector poderia ser substituído por um banco de dados vetorial dedicado se a escala exigir, o Phoenix poderia ser trocado por outra ferramenta de observability compatível com OTel, e o pilot light poderia evoluir para warm standby ou ativo-ativo se o SLA exigir. Os princípios por trás do design — separação de responsabilidades, deployments controlados, telemetria autohospedada, melhoria contínua com supervisão humana — se aplicam independentemente das ferramentas específicas escolhidas.

AI Platform Engineer & Full-Stack Developer
Building Enterprise Integrations & Automations
- O que é realmente um LLM — e como medi-lo com o Artificial Analysis - 12 de setembro de 2026
- AI SDLC: um compêndio de boas práticas para desenvolver com IA - 19 de junho de 2026
- Agentic Patterns e as muitas faces do RAG - 25 de maio de 2026