
Arquitectura de un Agente — Infraestructura en Producción
Este artículo detalla un posible diseño para una infraestructura de agente de grado de producción en AWS.
No existe una única arquitectura correcta para implementar un agente de IA en producción. El diseño adecuado depende de su escala, requisitos de cumplimiento y cuánta complejidad operativa esté dispuesto a soportar. Lo que sigue es una opción concreta — no la única manera, sino un enfoque fundamentado y de grado de producción que refleja decisiones reales de infraestructura.
Compute — AWS ECS Fargate
Dos clústeres: producción (siempre activo, alta disponibilidad) y desarrollo (50% de uptime, escala a cero fuera del horario laboral). Cada uno ejecuta dos servicios.
- La aplicación del agente maneja las llamadas al LLM, la orquestación de los diferentes nodos, la coordinación de herramientas y una interfaz administrativa. Para RAG, consulta
pgvector. Para CAG, carga los payloads de contexto completo directamente. Dimensionado en1 vCPU / 2 GB. - El proxy MCP abstrae la orquestación de los diferentes servidores MCP, enrutando llamadas a herramientas hacia MCPs externos. Desacoplado del runtime del agente — permite agregar o cambiar MCPs sin tener que hacer un nuevo deployment de la aplicación principal. También de
1 vCPU / 2 GB.
Alta Disponibilidad en Producción
Mínimo dos tareas distribuidas en múltiples Zonas de Disponibilidad. Las tareas poco saludables se dan de baja y se reemplazan automáticamente. Los rolling deployments se ejecutan a un 100% mínimo saludable / 200% máximo — cero tiempo de inactividad. El Auto Scaling ajusta la cantidad de tareas basándose en objetivos de CPU y memoria vía CloudWatch.
Clúster de Desarrollo
El clúster de desarrollo hace más que servir de staging. El entrenamiento, la evaluación y las pruebas de integración se ejecutan aquí dentro de la misma ventana del 50% de uptime. Sin tareas programadas por separado, sin costo extra de compute. Escala a cero fuera de horario mediante la programación de servicios de ECS.
CI/CD — GitLab
GitLab impulsa todo el pipeline de deployment. Los commits a la branch de staging activan el Eval Pipeline dentro del clúster de desarrollo. Aprobar la evaluación desbloquea la etapa de deployment, la cual promueve los cambios a producción a través de un rolling update de ECS. Los cambios en el prompt, actualizaciones de modelos y cambios en la configuración del agente pasan todos por el mismo pipeline — nada llega a producción sin pasar primero por una evaluación automatizada. Asumimos que GitLab es parte de la plataforma existente, por lo que no hay costo adicional de infraestructura.
En un evento de failover de DR, el pipeline de GitLab es redirigido a la región de DR. Misma definición de pipeline, mismas validaciones, diferente objetivo de deployment.
Ingestión de KB — AWS Lambda
El pipeline de ingestión se ejecuta en modo serverless. Convierte datos fuente sin procesar en contenido estructurado y limpio, escribiendo los embeddings en pgvector para RAG y preparando payloads de contexto completo para CAG. Cero costo en reposo, facturado por invocación.
Observability — Arize Phoenix
Phoenix se ejecuta como un servicio Fargate autoalojado y construido específicamente para la observability de LLM. Rastrea toda la cadena del agente — llamadas al LLM, ejecución de herramientas vía MCP, rutas de recuperación y respuestas del modelo. Dimensionado en 0.5 vCPU / 1 GB. Almacena todos los datos de trace en la instancia existente de RDS PostgreSQL — no se requiere una capa de almacenamiento separada.
Toda la telemetría se mantiene in-VPC. Ningún dato sale a un SaaS de terceros.
CloudWatch maneja la capa de infraestructura — métricas de ECS, seguimiento de objetivos de Auto Scaling y alarmas por fallas de tareas o umbrales de RDS. Phoenix maneja la cadena del LLM. Los dos se complementan en lugar de superponerse.
Almacenamiento — Una Instancia RDS, Cuatro Funciones
Estrategia de Almacenamiento: Una sola instancia RDS
Consolidar la configuración de la app, memoria conversacional, almacenamiento vectorial y trazas de Phoenix en una sola instancia db.m7g.large (2 vCPU, 8 GB RAM) es una decisión que equilibra costo con capacidad real de carga. A diferencia de las instancias burstable de la familia t4g, la m7g.large entrega sus 2 vCPUs completos de forma sostenida — sin créditos de CPU, sin degradación bajo carga continua. Esto es crítico cuando las búsquedas vectoriales de pgvector compiten con las escrituras de telemetría de Phoenix, ya que ambas cargas son intensivas en CPU y pueden coincidir bajo concurrencia real.
- Capacidad: Con 2 vCPUs dedicados y 8 GB de RAM, esta instancia soporta cómodamente hasta 80 usuarios concurrentes ejecutando búsquedas vectoriales, escrituras de telemetría y consultas de memoria conversacional de forma simultánea. Los 8 GB de RAM también permiten que pgvector mantenga una porción significativa del índice vectorial en memoria, reduciendo la presión sobre el disco.
- Criterio de Escalado: Si el tráfico concurrente sostenido supera consistentemente los 80 usuarios, el siguiente paso natural es separar Phoenix a su propia instancia (ej.
db.t4g.small— la telemetría no está en el camino crítico de la request, así que una instancia burstable alcanza) y considerar un escalado vertical de la instancia principal adb.m7g.xlarge. Alternativamente, migrar pgvector a una base de datos vectorial dedicada si el índice crece más allá de lo que una sola instancia PostgreSQL puede servir eficientemente.
La instancia PostgreSQL (db.m7g.large, 50 GB gp3) cuenta con snapshots diarios y una standby replica Multi-AZ. En caso de falla, RDS realiza un failover automático hacia la réplica de respaldo sin pérdida de datos.
Redes — ALB con SSO
Un solo ALB se sitúa frente a la Interfaz de Administración para la configuración del agente, edición de prompts, administración de herramientas y revisión human-in-the-loop. Terminación TLS y autenticación OIDC a través de Okta, o cualquier otro proveedor de identidad (IdP). El endpoint de revisión de estado del ALB es monitoreado por Route 53 como el disparador del failover de DR.
Recuperación ante Desastres (DR) — Pilot Light Multi-Región
El stack primario se ejecuta en us-east-1. La región de DR es us-west-2.
La replicación asíncrona de RDS entre regiones alimenta una réplica de lectura en us-west-2. El retraso de replicación es generalmente inferior a un minuto, lo que da un RPO de menos de un minuto. En un failover regional, la réplica es promovida a una base de datos principal independiente y el stack de DR apunta hacia ella.
Todos los clústeres Fargate en la región de DR operan con un recuento deseado de cero bajo operaciones normales — no hay tareas ejecutándose; el compute de la aplicación se inicia durante el failover mientras el resto de la infraestructura de DR permanece pre-provisionada. Este es el patrón pilot light. Las imágenes de contenedores están disponibles a través de la replicación interregional de ECR. Las comprobaciones de estado de Route 53 monitorean el ALB principal. Al fallar, el DNS cambia al ALB de DR con un TTL de 60 segundos. GitLab redirige hacia us-west-2. ECS escala los clústeres de DR. Phoenix en la región de DR se activa y apunta a la réplica promovida. El pipeline Lambda de KB en us-west-2 — ya desplegado de forma idéntica — comienza a escribir en la base de datos promovida.
El RTO con esta configuración es de aproximadamente 15 minutos dependiendo de qué tan rápido se detecte la falla y se dispare la secuencia de DR. Si el SLA exige un RTO de menos de cinco minutos, los clústeres Fargate de DR deberían operar con un recuento deseado de uno (warm standby) en lugar de cero, lo cual agrega aproximadamente $72 por mes.
El diseño activo-activo multi-región es una arquitectura completamente diferente — requiere gestión de estado distribuido y resolución de conflictos para las escrituras en RDS. Para la mayoría de las cargas de trabajo de agentes, el DR en modo pilot light con un RTO de aproximadamente 15 minutos es el equilibrio adecuado.
El Bucle de Mejora Continua
Sin un bucle de retroalimentación, el agente se desvía. La calidad del prompt se degrada, el conocimiento se vuelve obsoleto y nadie se da cuenta hasta que los usuarios se quejan. Este bucle se ejecuta dentro del clúster de desarrollo y protege cada cambio detrás de una evaluación automatizada y aprobación humana.
- Análisis de Interacción: Extrae los registros de conversación de RDS y los datos de trace de Phoenix. Un LLM clasifica la calidad de la interacción y revela patrones de degradación — respuestas de baja confianza, métodos de respaldo (fallbacks), fallas en llamadas a herramientas, correcciones de usuarios, sesiones abandonadas.
- Ajuste de Prompt y CAG: Propone cambios en las instrucciones del sistema, ejemplos few-shot, guardrails y plantillas de prompt. Para CAG, activa la Lambda de KB para regenerar payloads de contexto obsoletos. Todos los cambios son versionados y reciben commit en una branch de staging en GitLab.
- Evaluación Automatizada: GitLab detecta el commit en staging y activa el Eval Pipeline dentro del clúster de desarrollo. Regresión del conjunto de datos dorado (golden dataset), comparación A/B, benchmarks de latencia, corrección de las llamadas a herramientas. Si aprueba — se desbloquea la etapa de deploy. Si falla — el pipeline se detiene.
- Human-in-the-Loop: Los resultados de la evaluación, los diffs y las comparaciones de antes/después se muestran en la Interfaz de Administración vía el ALB. Se requiere aprobación explícita. Sin excepciones.
- Promoción a Producción: GitLab ejecuta el rolling update de ECS al clúster de producción en
us-east-1. Phoenix monitorea las primeras horas de tráfico. Retroceso (rollback) automático si se detecta una regresión.
Las interacciones de producción alimentan el siguiente ciclo. El bucle se sostiene a sí mismo.
Costo Mensual de Infraestructura
Región Primaria (us-east-1):
- Fargate Producción (2 servicios × 2 tareas, 1 vCPU / 2 GB) — $144.16
- Fargate Desarrollo (2 servicios × 1 tarea, 50% uptime) — $36.04
- Phoenix — $18.02
- Lambda — ~$1.00
- RDS Multi-AZ + pgvector (db.m7g.large, 50 GB gp3) — $256.78
- ALB + CloudWatch + ECR + Secrets — $28.03
- Total Primario — ~$484/mes
Región de DR (us-west-2, pilot light):
- RDS réplica de lectura interregional (db.m7g.large, 50 GB gp3) — $128.39
- ALB pre-provisionado — $16.00
- Comprobaciones de estado de Route 53 + enrutamiento de failover — $4.00
- ECR replicación interregional — ~$1.00
- Clústeres Fargate (deseado: 0, inactivo) — $0.00
- Phoenix DR + Lambda DR (inactivo) — $0.00
- DR adicional — ~$149/mes
Total con DR — ~$633/mes
La réplica de RDS entre regiones representa la mayor parte del costo de DR. Fargate no genera costo mientras no haya tareas ejecutándose. Activar el compute de DR en un failover real agrega los costos de Fargate y Phoenix para ese mes, pero son picos únicos en lugar de gastos continuos.
La diferencia de costo frente a una instancia burstable equivalente en Multi-AZ (db.t4g.medium, ~$106/mes incluyendo almacenamiento) es de aproximadamente $150/mes en la región primaria. Este incremento elimina por completo el riesgo de degradación por agotamiento de créditos de CPU — un trade-off justificado cuando se necesita rendimiento predecible bajo concurrencia real.
Aclaración sobre la Capacidad de Carga
Esta arquitectura base, con sus dimensiones iniciales (contenedores Fargate de 1 vCPU / 2 GB y una instancia RDS db.m7g.large), está diseñada para una carga baja a moderada con capacidad de absorber picos de concurrencia real.
- Tráfico Normal: Para un volumen de 100 a 200 usuarios totales con uso esporádico o distribuido, este diseño es altamente eficiente, tolerante a fallos y mantendrá los costos a raya.
- Tráfico Concurrente: La instancia
db.m7g.largesoporta hasta 80 usuarios interactuando simultáneamente sin degradación de rendimiento, gracias a sus 2 vCPUs dedicados (no burstable) y 8 GB de RAM. Las búsquedas vectoriales de pgvector, las escrituras de telemetría de Phoenix y las consultas de memoria conversacional pueden ejecutarse en paralelo sin competir por créditos de CPU. La capa de cómputo de Fargate escalará de forma fluida mediante el Auto Scaling de ECS para absorber la carga correspondiente. - Más allá de 80 concurrentes: Si la concurrencia sostenida supera consistentemente este umbral, el primer paso es separar Phoenix a su propia instancia RDS y considerar un escalado vertical de la instancia principal a
db.m7g.xlarge(4 vCPU, 16 GB RAM).
Resumen del Stack
Dos clústeres Fargate (Producción HA, Desarrollo 50%). Un servicio Fargate para Phoenix. Una función Lambda. Una instancia RDS (Multi-AZ, db.m7g.large, pgvector, cuatro funciones). Un ALB con SSO. GitLab para CI/CD y bloqueo de despliegues. CloudWatch para infraestructura. Route 53 para failover de DNS. DR pilot light multi-región en us-west-2. Aprobación humana validando cada cambio en producción.
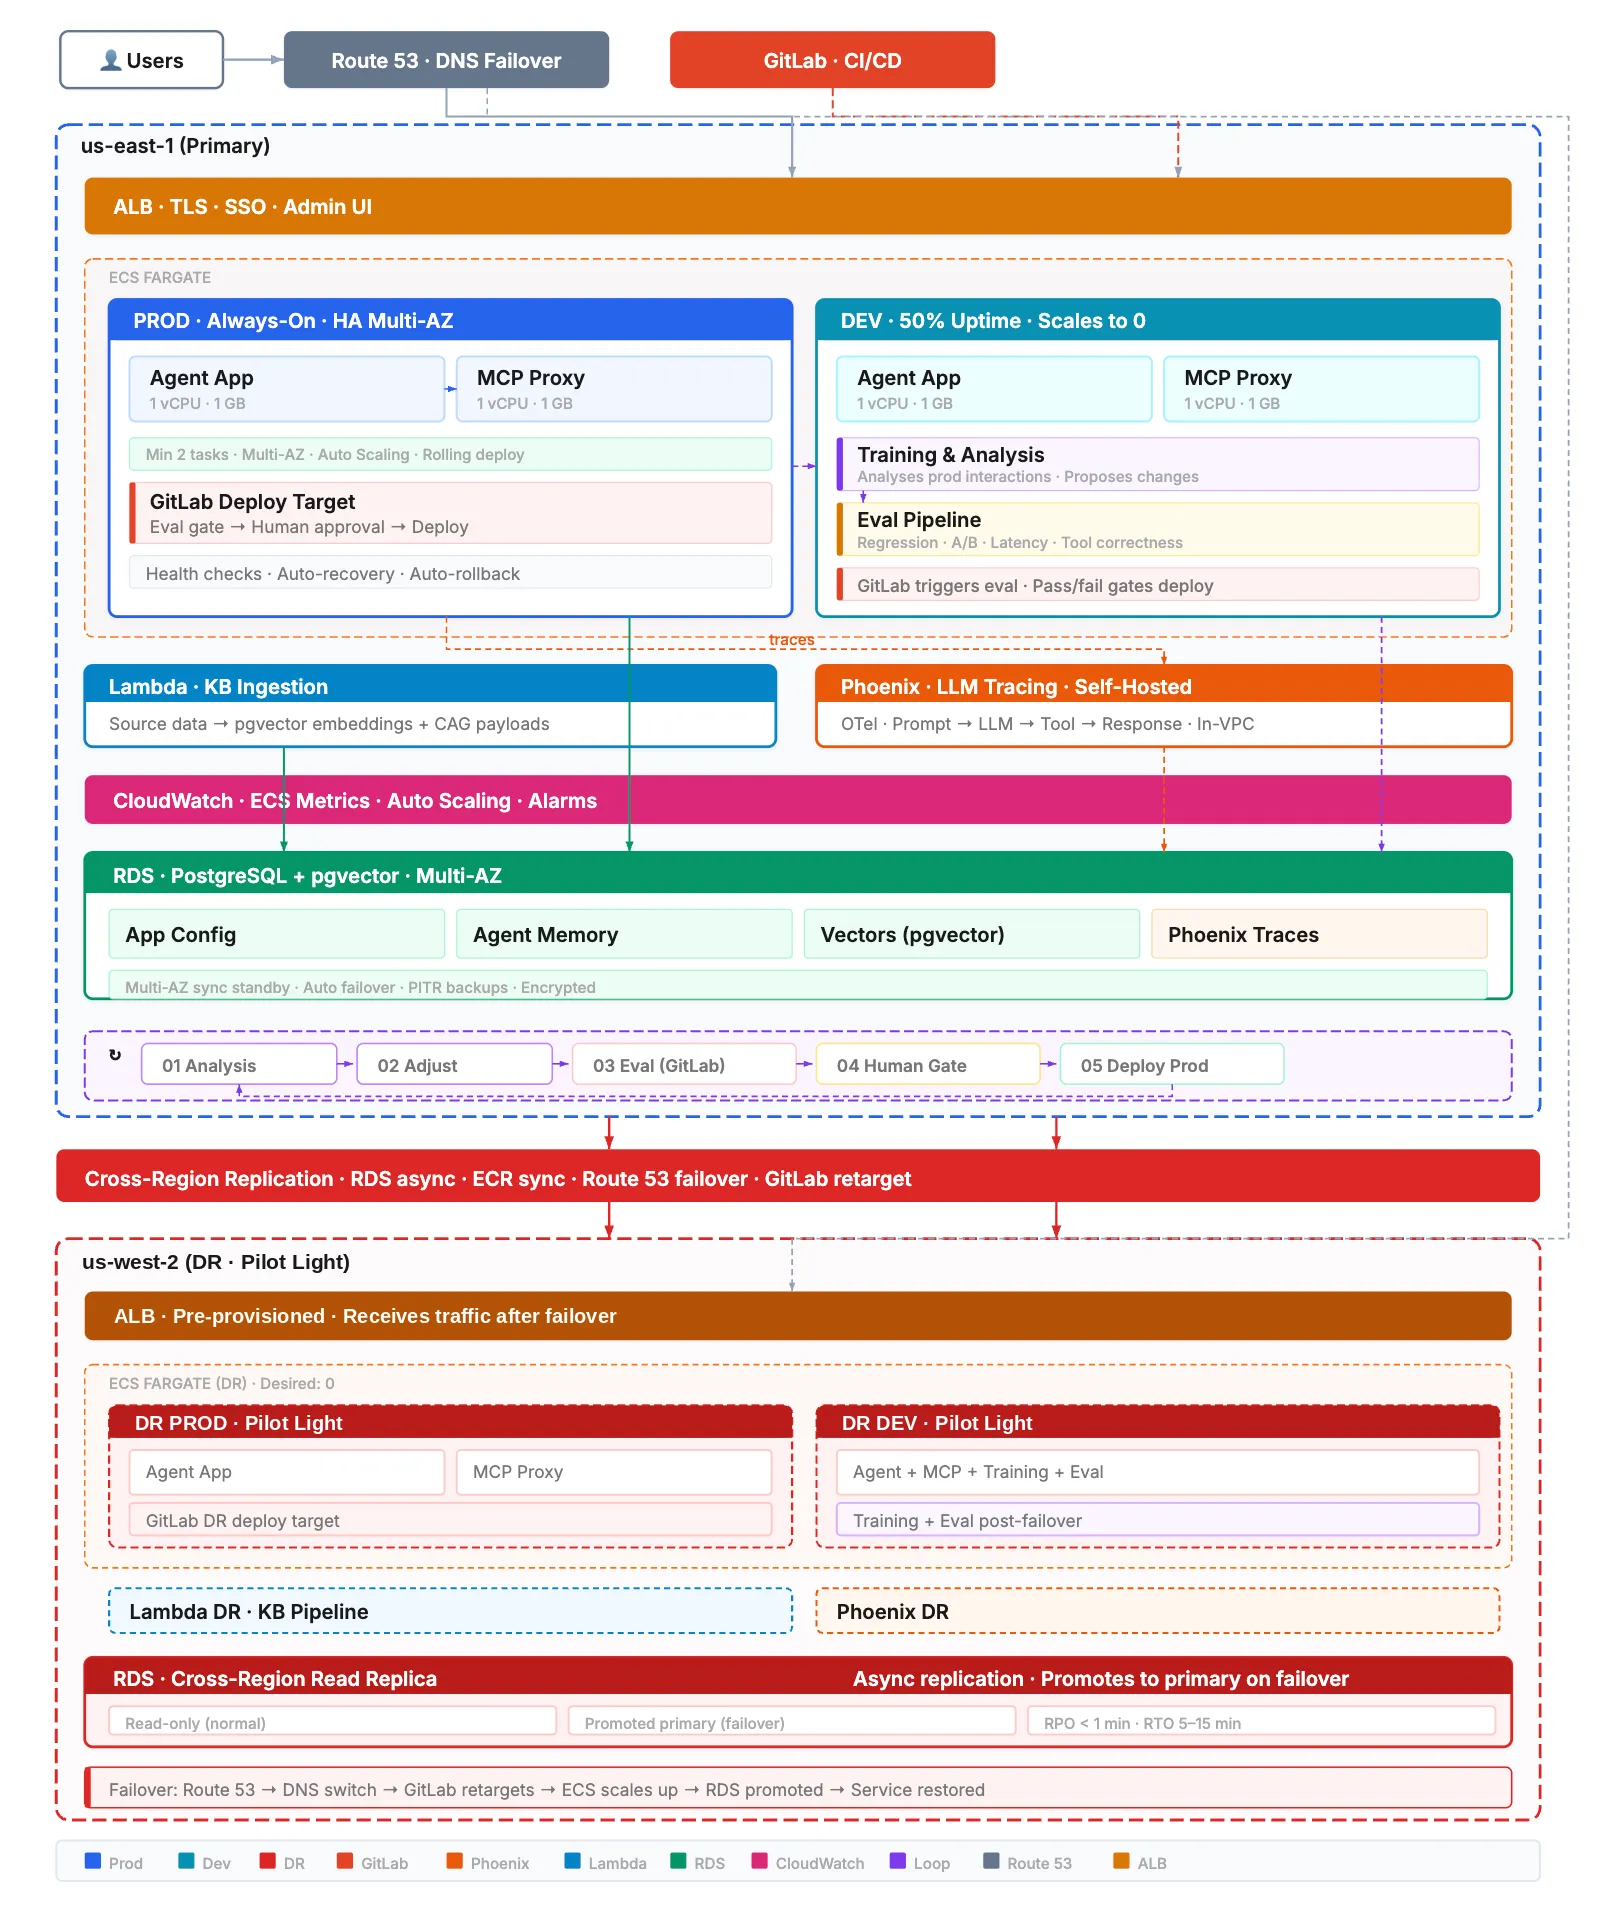
Esta es una forma de construirlo. Los componentes son intercambiables — pgvector podría ser reemplazado con una base de datos vectorial dedicada si la escala lo exige, Phoenix podría ser intercambiado por otra herramienta de observability compatible con OTel, y el pilot light podría ser escalado a warm standby o activo-activo si el SLA lo requiere. Los principios detrás del diseño — separación de responsabilidades, deployments controlados, telemetría autoalojada, mejora continua con supervisión humana — se aplican independientemente de las herramientas específicas elegidas.

AI Platform Engineer & Full-Stack Developer
Building Enterprise Integrations & Automations
- Qué es realmente un LLM — y cómo medirlo con Artificial Analysis - septiembre 12, 2026
- AI SDLC: un compendio de buenas prácticas para desarrollar con IA - junio 19, 2026
- Agentic Patterns y las Muchas Caras del RAG - mayo 25, 2026